
大模型技术全解析:从基础模型到前沿架构
文章系统梳理了大语言模型的发展历程,从基础模型阶段、能力探索阶段到突破发展阶段,详细解析了 Transformer 和 MoE 等核心架构,介绍了预训练、微调、奖励建模和强化学习的构建流程,并探讨了指令微调、参数高效微调及基于人类反馈的强化学习等对齐技术。通过 DeepSeek 等实例,展示了通用模型与推理模型的区别与应用场景,为开发者提供了全面的大模型技术指南。
一、大模型发展历程
大语言模型的发展历程虽然只有不到 5 年,但是发展速度相当惊人,截至 2025 年 2 月,国内外有超过百种大语言模型相继发布。特别是 2024 年 12 月 DeepSeek-V3 和 2025 年 1 月 DeepSeek-R1 模型的开源,不仅在训练效率和思考推理上取得了突破,还赢得了国际社会对中国人工智能技术的高度认可。中国人民大学赵鑫教授团队在《大语言模型》书中按照时间线给出了 2019 年至 2024 年 6 月比较有影响力并且模型参数量超过 100 亿个的大语言模型,我们在此基础上扩展到 2025 年 2 月,如图 1.2 所示。大语言模型的发展可以粗略地分为如下三个阶段:基础模型阶段、能力探索阶段和突破发展阶段。
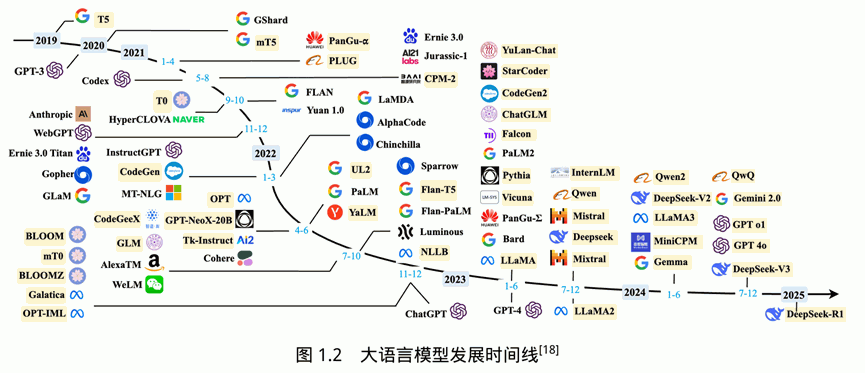
基础模型阶段主要集中于 2018 年至 2021 年。
2017 年,Vaswani 等人提出了 Transformer 架构,在机器翻译任务上取得了突破性进展。
2018 年,Google 和 OpenAI 分别提出了 BERT 和 GPT-1 模型,开启了预训练语言模型时代。BERT-Base 版本的参数量为 1.1 亿个,BERT-Large 版本的参数量为 3.4 亿个,GPT-1 的参数量为 1.17 亿个。这在当时,比其他深度神经网络的参数量,已经有了数量级上的提升。
2019 年 OpenAI 发布了 GPT-2,其参数量达到 15 亿个。此后,Google 也发布了参数规模为 110 亿个的 T5 模型。
2020 年,OpenAI 进一步将语言模型的参数量扩展到 1750 亿个,发布了 GPT-3。此后,国内也相继推出了一系列的大语言模型,包括百度的 ERNIE、华为的 PanGU-α 等。此阶段的研究主要集中在语言模型本身,对仅编码器(Encoder-only)、编码器-解码器(Encoder-Decoder)、仅解码器(Decoder-only)等各种类型的模型结构都有相应的研究。模型大小与 BERT 类似,通常采用预训练微调范式,针对不同下游任务进行微调。这些模型参数量大都在 10 亿个以上,由于微调的计算量很大,这类模型的影响力在当时相较 BERT 类模型有不小的差距。
能力探索阶段集中于 2019 年至 2022 年。
由于大语言模型很难针对特定任务进行微调,研究人员开始探索在不针对单一任务进行微调的情况下如何发挥大语言模型的能力。2019 年,Radford 等人在文献中使用 GPT-2 模型研究了大语言模型在零样本情况下的任务处理能力。在此基础上,Brown 等人在 GPT-3 模型上研究了通过语境学习进行少样本学习的方法,将不同任务的少量有标注的实例拼接到待分析的样本之前输入语言模型,语言模型根据实例理解任务并给出正确的结果。基于 GPT-3 的语境学习在 TriviaQA、WebQS、CoQA 等评测集合中都展示出了非常强的能力,在有些任务中甚至超过了此前的有监督方法。上述方法不需要修改语言模型的参数,模型在处理不同任务时无须花费大量计算资源进行模型微调。仅依赖语言模型本身,其性能在很多任务上仍然很难达到有监督学习(Supervised Learning)的效果,因此研究人员提出了指令微调方案,将大量各类型任务统一为生成式自然语言理解框架,并构造训练数据进行微调。大语言模型能一次性学习数千种任务,并在未知任务上展现出很好的泛化能力。
2022 年,Ouyang 等人提出了使用“有监督微调 + 强化学习”的 InstructGPT 方法,该方法使用少量有监督数据就可以使大语言模型服从人类指令。Nakano 等人则探索了结合搜索引擎的问题回答方法 WebGPT。这些方法在直接利用大语言模型进行零样本和少样本学习的基础上,逐渐扩展为利用生成式框架针对大量任务进行有监督微调的方法,有效提升了模型的性能。
突破发展阶段以 2022 年 11 月 ChatGPT 的发布为起点。
ChatGPT 通过一个简单的对话框,利用一个大语言模型就可以实现问题回答、文稿撰写、代码生成、数学解题等过去自然语言处理系统需要大量小模型定制开发才能分别实现的能力。它在开放领域问答、各类自然语言生成式任务及对话上下文理解上所展现出来的能力远超大多数人的想象。2023 年 3 月 GPT-4 发布,相较于 ChatGPT,GPT-4 有非常明显的进步,并具备了多模态理解能力。GPT-4 在多种基准考试测试上的得分高于 88% 的应试者,包括美国律师资格考试(Uniform Bar Exam)、法学院入学考试(Law School Admission Test)、学术能力评估(Scholastic Assessment Test,SAT)等。GPT-4o 是 OpenAI 于 2024 年 5 月发布的多模态大模型,其中“o”代表“omni”即“全能”。它能接受文本、音频和图像组合输入并生成文本、音频和图像的任意组合输出,可处理 50 种语言,在 232 毫秒内对音频输入做出反应,性能较 GPT-4 有显著提升。2024 年 9 月 OpenAI 又推出的全新推理模型 GPT-o1,在复杂推理任务上表现卓越,能通过内部思维链模拟人类思考,在数学、科学等领域超越人类专家及 GPT-4o。国内外各大公司和研究机构相继发布了此类系统,包括复旦大学的 MOSS、阿里巴巴的 Qwen、深度求索的 DeepSeek、Google 的 Gemini、xAI 的 Grok、科大讯飞的星火大模型、智谱的 ChatGLM 等。
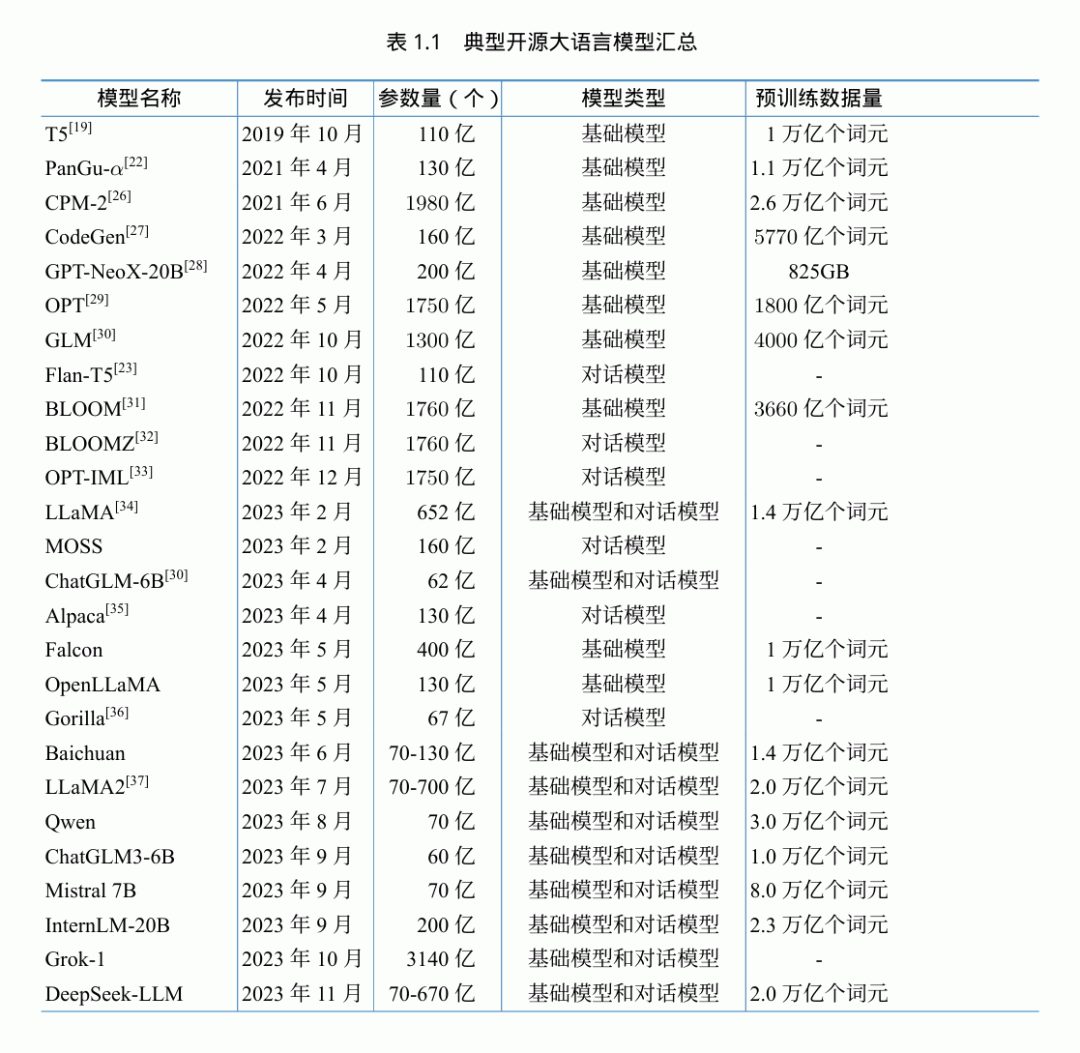
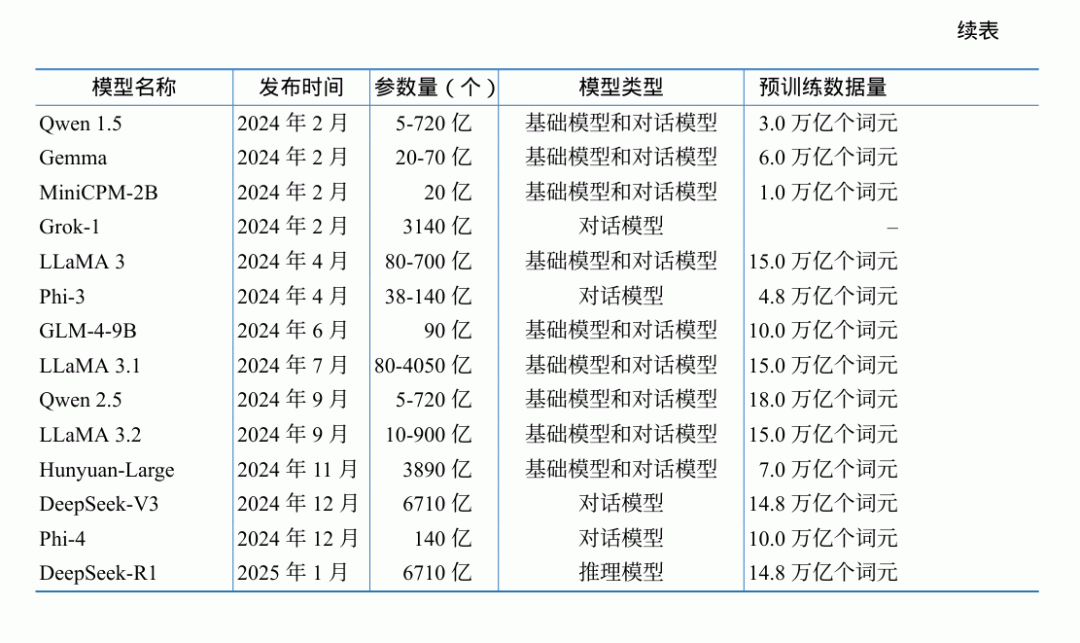
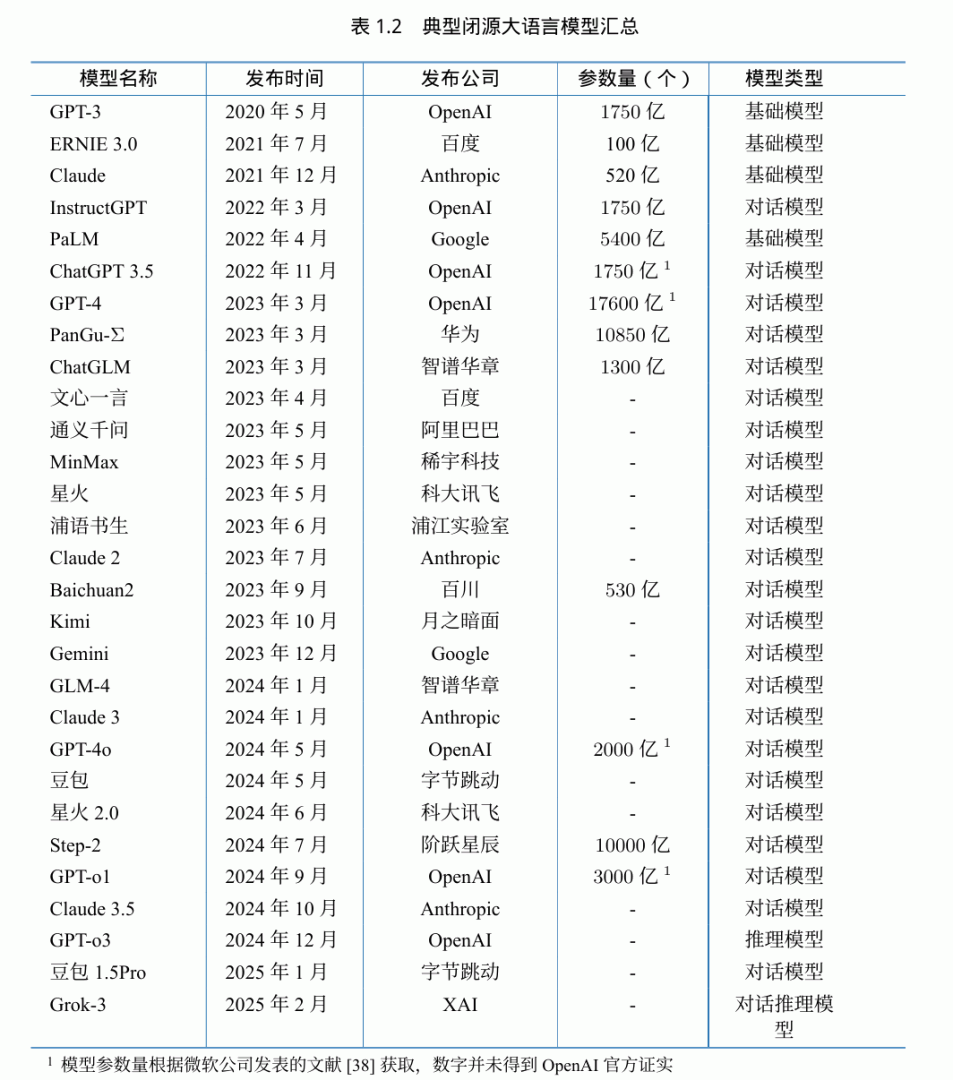
表 1.1 和表 1.2 分别给出了截至 2025 年 2 月典型开源和闭源大语言模型的基本情况。可以看到,从 2022 年开始,大语言模型的数量呈爆发式的增长,各大公司和研究机构都在发布不同类型的大语言模型。模型类型中,基础模型是指仅经过预训练的模型;对话模型是指在预训练模型基础上经过有监督微调和强化学习训练的模型,具备对话和完成任务的能力;推理模型是指专注于逻辑推理增强的大语言模型。
二、基础模型、语言模型、通用模型和推理模型
我们通常会看到某模型研发机构开源了 base 模型、chat 模型。
base 模型,也就是基础模型,是在海量不同文本上训练出来的预测后续文本的模型。后续文本未必是对指令和对话的响应。
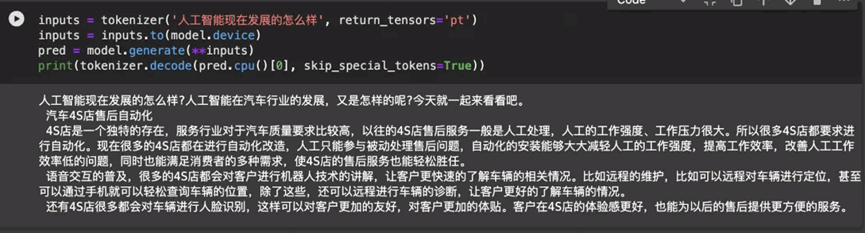
chat 模型,也就是对话模型,是在 base 基础上通过对话记录(指令-响应)继续做微调和强化学习,让它接受指令和用户对话时,续写出来的是遵循指令的、人类预期的 assistant 的响应内容。
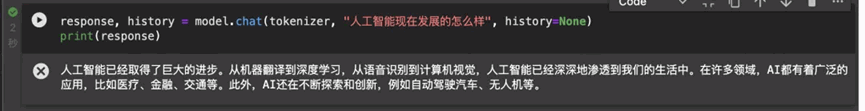
此基础之上,又引出通用大模型和推理大模型。
通用大模型,更严谨的叫法是指令大模型,它的优点是响应用户请求的速度极快,并且对多模态(语音、图片、视频等)的支持非常好,更适合处理固定、规律、不太需要强大推理能力的任务,比如大文本、海量数据的处理等。通用大模型的缺点在生成效果方面,或者说它给的回答很依赖指令。你甚至需要一步一步地告诉它具体怎么做,你告知得越清晰,写提示词的技术越高超,它给你的反馈就越好。否则,通用大模型可能生成一堆文字垃圾,不能很好地处理创意性、发散性、思维层次更高的灵活性任务。当然,推理大模型的缺点也非常明显,因为它在正式回答你之前,要对你的问题做复杂的推理,所以响应速度往往比通用大模型慢。截至 2025 年 3 月它对多模态和大文本的处理还非常吃力,几乎没有办法完成规模性任务。
推理大模型则专注于复杂问题的逻辑推理和多步推导能力。通过强化学习和思维链(Chain of Thought, CoT)等技术优化,推理大模型能够在数学推导、代码生成、复杂问题拆解等任务中表现出色。例如,在需要多步骤逻辑推理的场景,如科学计算、论文生成或跨领域问题解决中,推理大模型能够提供更高的准确性和深度。
以下以 DeepSeek-V3 和 DeepSeek-R1 为例,详细分析它们的定义、区别及适用场合。
DeepSeek-V3 是一个典型的通用大模型,采用混合专家(MoE, Mixture of Experts)架构,总参数规模达 671B,但在处理每个 token 时仅激活 37B 参数,通过创新技术实现高效计算资源利用。它在自然语言处理、知识问答、内容生成等多任务场景中表现出色,尤其擅长多语言处理和常规自然语言理解任务。DeepSeek-V3 的设计目标是提供高性价比的 AI 服务,满足广泛的商业和研究需求。
DeepSeek-R1 是一个典型的推理大模型,更专注于逻辑推理、数学计算、代码生成等需要深度思考和分析的任务。它基于 DeepSeek-V3-Base 模型训练,采用了纯强化学习(RL, Reinforcement Learning)训练范式,开辟了一条独特的训练路径。它通过大规模强化学习技术,在极少人工标注数据的情况下显著提升了推理能力,尤其在数学、代码生成和自然语言推理等任务上表现卓越。
DeepSeek-R1 在训练中展现出自我反思、评估先前步骤、自发寻找替代方案等复杂行为,具备强大的深度推理能力。所以在评测的榜单(这些评测一般注重的是结果,而不是时间)上,DeepSeek-R1 的分数是高于 DeepSeek-V3 的。
DeepSeek-V3 和 DeepSeek-R1 都是基于同一个基础架构,但它们在设计目标、训练方法和性能表现上存在显著差异:
| 对比维度 | DeepSeek-V3(通用大模型) | DeepSeek-R1(推理大模型) |
|---|---|---|
| 设计目标 | 旨在提供高效、可扩展的自然语言处理解决方案,注重综合场景的适用性,面向广泛的商业和研究需求。 | 专注于提升模型的推理能力,特别是在数学、代码和逻辑推理等高难度任务中,追求深度思考和分析的顶尖表现。 |
| 训练方法 | 采用传统的预训练结合监督微调(SFT, Supervised Fine-Tuning)范式,并通过混合专家架构优化训练效率。 | 在 DeepSeek-V3-Base 基础上,通过大规模强化学习从基础模型中激发推理能力,采用冷启动策略和群体相对策略优化(GRPO, Group Relative Policy Optimization)等技术。 |
| 性能表现 | 在通用自然语言处理任务中表现出色,尤其在响应速度和多语言理解方面具有优势。 | 在复杂推理任务领域表现卓越,特别是在数学推理、代码生成和逻辑推理等任务中,性能超越许多同类模型。 |
| 资源消耗 | 由于 MoE 架构的优化,计算成本较低,资源消耗较少,适合大规模部署和并发处理。 | 虽然也采用 MoE 架构,但强化学习优化的推理过程需要更多计算资源支持复杂思考——也就是一说话就先“思考”。 |
1 DeepSeek-V3 的适用场合
由于其通用性、高性价比和快速响应的特点,DeepSeek-V3 广泛适用于以下场景:
- 内容创作:帮助自媒体创作者快速生成结构清晰、内容丰富的文章。
- 对话系统:支持智能客服和聊天机器人,能够准确理解用户问题并提供合适回答。
- 信息检索与问答:适用于复杂问题解答和信息提取,帮助科研人员从海量文献中筛选信息。
- 多语言翻译:支持多语言文档处理和实时翻译,满足国际化需求。
- 教育辅导:提供个性化学习辅导,解答学生疑问。
DeepSeek-V3 特别适合需要实时处理和大量并发请求的应用场景,能够满足企业对 AI 服务的日常需求。
2 DeepSeek-R1 的适用场合
凭借其强大的推理能力,DeepSeek-R1 适用于以下需要深度思考和分析的场景:
- 数学问题求解:在高等数学难题、物理建模计算等场景中提供精准答案。
- 代码生成:为程序员提供高效的代码辅助支持,提升编程效率和代码质量。
- 逻辑推理:在学术研究、问题解决应用程序和决策支持系统中发挥作用。
- 教育工具:帮助学生进行逻辑思维训练,培养解决复杂问题的能力。
三、大语言模型的构建流程
根据 OpenAI 联合创始人 Andrej Karpathy 在微软 Build 2023 大会上公开的信息,OpenAI 使用的大语言模型构建流程如图 1.3 所示,主要包含四个阶段:预训练、有监督微调、奖励建模和强化学习。这四个阶段都需要不同规模的数据集及不同类型的算法,会产出不同类型的模型,所需要的资源也有非常大的差别。
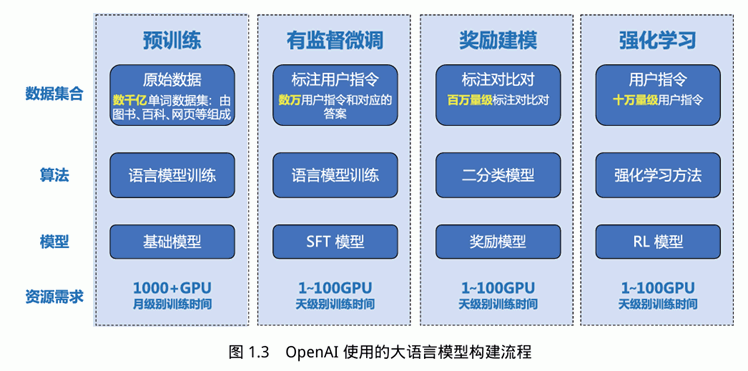
预训练(Pretraining)阶段需要利用海量的训练数据(数据来自互联网网页、维基百科、书籍、GitHub、论文、问答网站等),构建包含数千亿甚至数万亿单词的具有多样性的内容。利用由数千块高性能 GPU 和高速网络组成的超级计算机,花费数十天完成深度神经网络参数训练,构建基础模型(Base Model)。基础模型对长文本进行建模,使模型具有语言生成能力,根据输入的提示词,模型可以生成文本补全句子。有一部分研究人员认为,语言模型建模过程中隐含地构建了包括事实性知识(Factual Knowledge)和常识性知识(Commonsense)在内的世界知识(World Knowledge)。
根据文献中的介绍,GPT-3 完成一次训练的总计算量是 3640 PFLOPS,按照 NVIDIA A100 80GB GPU 和平均利用率达到 50% 计算,需要花费近一个月的时间使用 1000 块 GPU 完成。由于 GPT-3 的训练采用 NVIDIA V100 32GB GPU,其实际计算成本远高于上述计算。文献介绍了参数量同样是 1750 亿个的 OPT 模型,该模型训练使用 992 块 NVIDIA A100 80GB GPU,整体训练时间将近 2 个月。BLOOM 模型的参数量也是 1750 亿个,该模型训练一共花费 3.5 个月,使用包含 384 块 NVIDIA A100 80GB GPU 集群完成。可以看到,大语言模型的训练需要花费大量的计算资源和时间。LLaMA、Falcon、百川(Baichuan)等模型都属于基础语言模型。即便是 DeepSeek-V3 经过了大量的训练效率优化,甚至已经直接使用 PTX 进行汇编级优化,完成一次预训练仍然需要花费 266.4 万 H800 GPU 小时。由于训练过程需要消耗大量的计算资源,并很容易受到超参数影响,因此,如何提升分布式计算效率并使模型训练稳定收敛是本阶段的研究重点。
有监督微调(Supervised Fine-Tuning,SFT),也称为指令微调,利用少量高质量数据集,通过有监督训练使模型具备问题回答、翻译、写作等能力。有监督微调的数据包含用户输入的提示词和对应的理想输出结果。用户输入包括问题、闲聊对话、任务指令等多种形式和任务。利用这些有监督数据,使用与预训练阶段相同的语言模型训练算法,在基础模型的基础上进行训练,得到有监督微调模型(SFT 模型)。经过训练的 SFT 模型具备初步的指令理解能力和上下文理解能力,能够完成开放领域问答、阅读理解、翻译、生成代码等任务,也具备了一定的对未知任务的泛化能力。由于有监督微调阶段所需的训练数据量较少,SFT 模型的训练过程并不需要消耗大量的计算资源。根据模型的大小和训练数据量,通常需要数十块 GPU,花费数天时间完成训练。SFT 模型具备了初步的任务完成能力,可以开放给用户使用,很多类 ChatGPT 的模型都属于该类型,包括 Alpaca、Vicuna、MOSS、ChatGLM-6B 等。很多这类模型的效果非常好,甚至在一些评测中达到了 ChatGPT 的 90% 的效果。当前的一些研究表明,有监督微调阶段的数据选择对 SFT 模型效果有非常大的影响,因此构造少量并且高质量的训练数据是本阶段的研究重点。
奖励建模(Reward Modeling)阶段的目标是构建一个文本质量对比模型。对于同一个提示词,SFT 模型对给出的多个不同输出结果的质量进行排序。奖励模型可以通过二分类模型,对输入的两个结果之间的优劣进行判断。奖励模型与基础模型和 SFT 模型不同,奖励模型本身并不能单独提供给用户使用。奖励模型的训练通常和 SFT 模型一样,使用数十块 GPU,通过数天时间完成训练。由于奖励模型的准确率对强化学习阶段的效果有至关重要的影响,因此通常需要大规模的训练数据对该模型进行训练。Andrej Karpathy 在报告中指出,该部分需要百万量级的对比数据标注,而且其中很多标注需要很长时间才能完成。此外,奖励模型的泛化能力边界也是本阶段需要重点研究的一个问题。如果奖励模型的目标是针对系统所有的输出都能够高质量地进行判断,那么该问题的难度在某种程度上与文本生成等价,因此限定奖励模型应用的泛化边界是本阶段需要解决的问题。
强化学习(Reinforcement Learning,RL)阶段根据数十万条提示词,利用前一阶段训练的奖励模型,给出 SFT 模型对提示词回答结果的质量评估,并与语言模型建模目标综合得到更好的效果。该阶段使用的提示词数量与有监督微调阶段类似,数量在十万个量级,并且不需要人工提前给出该提示词所对应的理想回复。使用强化学习,在 SFT 模型的基础上调整参数,使最终生成的文本可以获得更高的奖励(Reward)。该阶段需要的计算量较预训练阶段也少很多,通常仅需要数十块 GPU,数天即可完成训练。文献给出了强化学习和有监督微调的对比,在模型参数量相同的情况下,强化学习可以得到相较于有监督微调好得多的效果。关于为什么强化学习相比有监督微调可以得到更好结果的问题,截至 2025 年 2 月还没有完整或得到普遍共识的解释。目前相对得到认可的观点是,强化学习使得模型具备更好的泛化能力。同时,Andrej Karpathy 也指出,强化学习并不是没有问题的,它会使基础模型的熵降低,从而减少模型输出的多样性。经过强化学习方法训练后的 RL 模型,就是最终提供给用户使用、具有理解用户指令和上下文的类 ChatGPT 系统。由于强化学习方法稳定性不高,并且超参数众多,使得模型收敛难度大,叠加奖励模型的准确率问题,使得在大语言模型上有效应用强化学习非常困难。
四、大模型基础架构
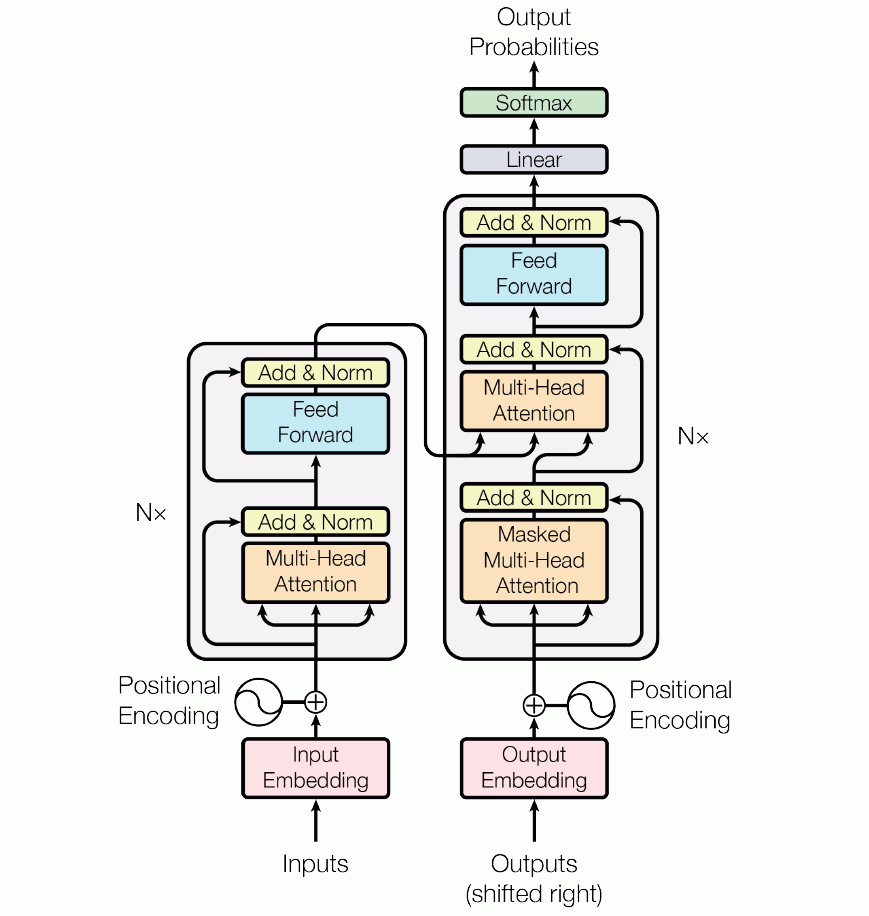
在深度学习的发展历程中,2017 年是一个分水岭。Google 的研究团队发表了一篇名为《Attention Is All You Need》的论文,提出了 Transformer 架构,Transformer 框架的问世代表着一个划时代的转折点。其独特的自注意力(Self-Attention)机制极大地提升了模型对序列数据的处理能力,在捕捉长距离依赖关系方面表现尤为出色。此外,Transformer 框架对并行计算的支持极大地加速了模型的训练过程。当前,绝大多数大语言模型均以 Transformer 框架为核心,并进一步演化出了三种经典架构,分别是 Encoder-only 架构、Decoder-only 架构以及 Encoder-Decoder 架构。这三种架构在设计和功能上各有不同。
第一个是仅编码器模型(Encoder-only),也叫自编码器模型;比如 BERT,让模型猜文本里被遮住的词是什么、做情感分析,让模型判断文本情感是积极还是消极。目标是:理解语言的任务。
第二个是仅解码器模型(Decoder-only),也叫自回归模型;如 GPT-2、GPT-3,通过预测下一个词来实现文本生成。目标:文本生成。
第三个是编码器和解码器模型(Encoder-Decoder),也叫序列到序列模型;比如 T5、BART,把一个序列转换为另外一个序列。目标:翻译、总结。
1、Transformer 架构
关于 Transformer 架构,在 Transformer 架构被提出之前,语言模型的主流架构主要是循环神经网络 RNN,其按照顺序逐字处理每一步,输出取决于先前的隐藏状态和当前的输入,要等上一个步骤完成后,才能进行当前的计算。因此,无法完成并行计算,训练效率低,而且 RNN 不擅长处理长序列,因为难以捕捉到长距离依赖性的语义关系。接下来,为了捕捉到长距离依赖性,也出现了 RNN 的改良版本,就是 LSTM 长短期记忆网络,但是这也并没有解决传统并行计算的问题,而且在处理非常长的序列时也依然受到限制。最后,Transformer 腾空出世了,它有能力学习输入序列里所有词的相关性和上下文,不会受到短时记忆的影响。能做到这一点的关键,在于 Transformer 的自注意力机制。也正如论文标题所说,Attention is all you need,注意力就是你所需要的一切。
简单来说,Transformer 在处理每个词的时候,不仅会注意这个词本身以及它附近的词,还会去注意输入序列里所有其他的词,然后赋予每个词不一样的注意力权重。权重是模型在训练过程中通过大量文本逐渐学习到的,因此,Transformer 有能力知道当前这个词和其他词之间的相关性有多强,然后去专注于输入里真正重要的部分。即使两个词的位置隔得很远,Transformer 依然可以捕获它们之间的依赖关系。举例:
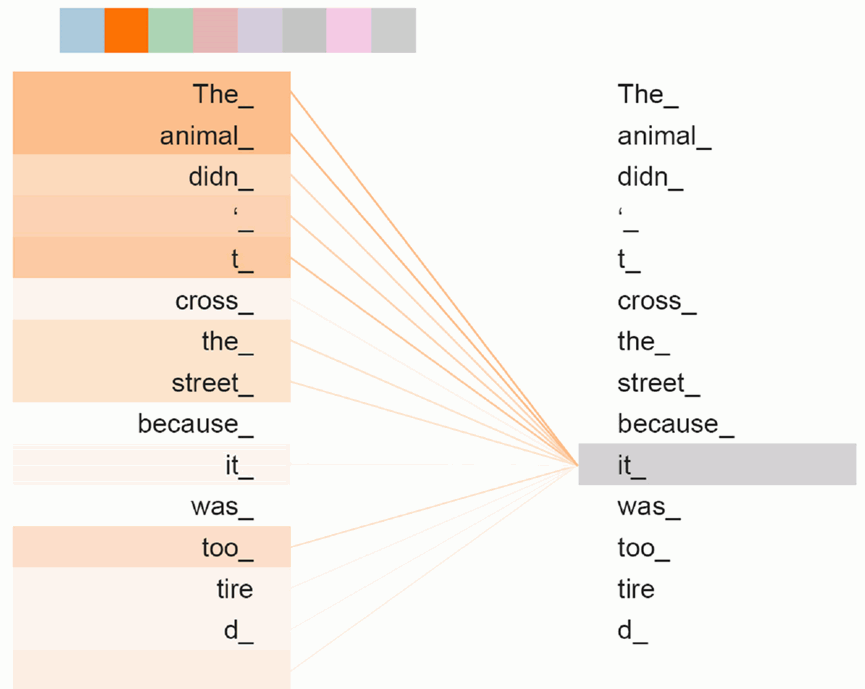
给出一个句子,使用一些关键词 animal 和 street 来描述 it 到底指代什么?
题目写出了一些关键词(如 animal、street)作为提示,其中这些给出的关键词就可以看作是 key,而整个的文本信息就相当于是 query,脑子里浮现的答案信息是 value,默认是 street。
第一次看到这段文本后,脑子里基本上浮现的信息就只有提示这些信息,此时,key 与 value = street 基本是相同的。
第二次进行深入理解后,脑子里想起来的东西越来越多,对 query 这一个句子,提取关键信息 tired 进行关联,这就是注意力作用的过程,通过这个过程,我们最终脑子里的 value 发生了变化,变成了 animal。
总结一下,使用一般注意力机制,是使用不同于给定文本的关键词表示它。而自注意力机制,需要用给定文本自身来表达自己,也就是说你需要从给定文本中抽取关键词来表述它,相当于对文本自身的一次特征提取。
Transformer 的目标是:通过预测出现概率最高的下一个词,来实现文本生成,这种效果有点像搜索引擎的自动补全。每当我们输入一个新的字或词,输入框就开始预测后面的文本,概率越高的排在越上面。
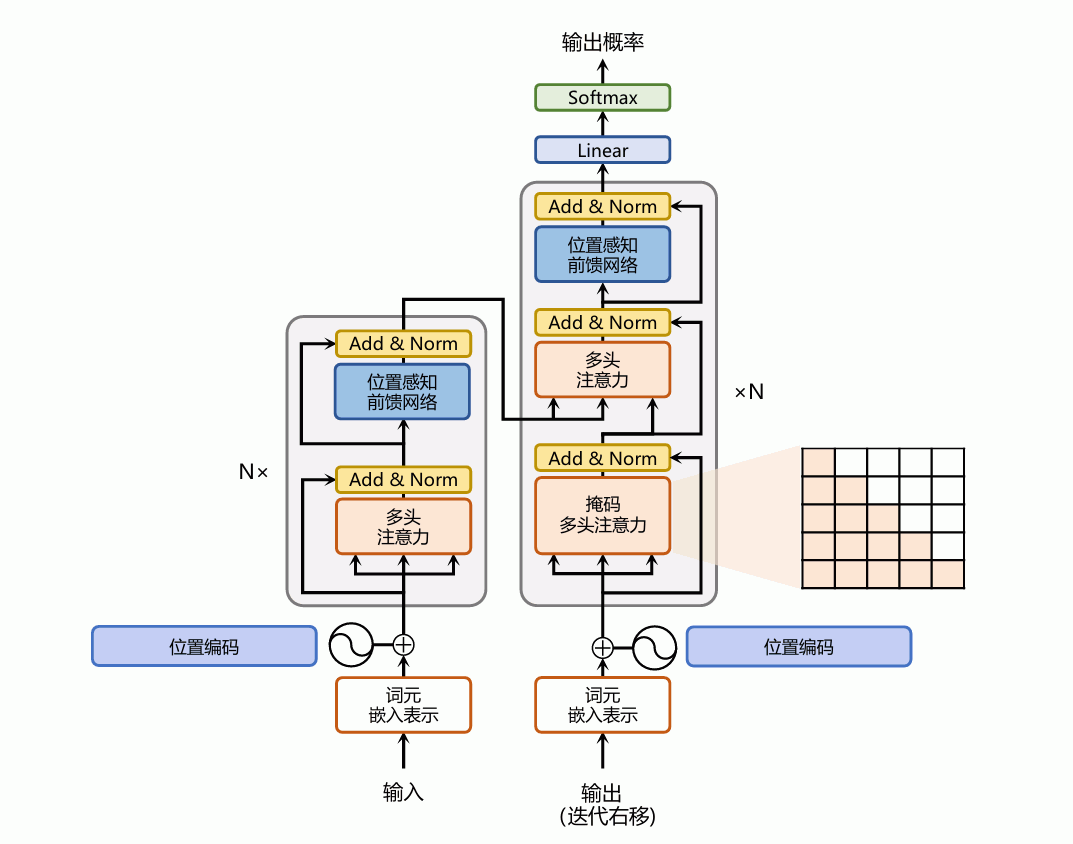
Transformer 架构有两个核心部分组成,编码器 Encoder 和解码器 Decoder。工作流程如下:
第一步:转换为计算机可以计算的向量 Token。中文的每个字,被理解为是文本的一个基本单位,翻译成不同的 token。这是指将输入文本分解为更小的单位,例如单词、字母或字符。在自然语言处理中,将文本分解为标记有助于模型理解语义和语法结构。当一个 Prompt 被发送给 GPT 时,它会被分解成多个 Token,这个过程被称为 Tokenizer。短单词可能每个词是一个 token,长单词可能被拆成多个 token。每个 token 会被用一个整数数字表示,这个数字被叫做 token ID。这是因为,计算机内部是无法储存文字的,任何字符最终都得用数字来表示。有了数字表示的输入文本后,再把它传入嵌入层。
第二步:Embedding 嵌入层。其作用是让每个 token 都用向量表示,向量可以被简单地看为一串数字。举例:假设把向量长度简化为 1—512,实际中向量长度可以非常长。为什么要用一串数字表示 token?重要原因是,一串数字能表达的含义是大于一个数字的,能包含更多语法、语义信息等等。这就好比对人的画像,如果只有男人和女人这两个属性,太少维度的描述,需要增加籍贯、身高、爱好和专业等维度,才能更好地刻画人的特征。多个数字就是多个特征,我们就可以进行更多维度的表示。嵌入层的向量里面包含了词汇之间语法、语义等关系。向量长度到底可以多长呢?在 Transformer 论文里,向量长度是 512,GPT-3 里设置为 12288,可以想象能包含多少信息。
第三步:位置编码。Transformer 的一项关键机制是位置编码。在语言里,顺序很重要,即使句子里包含的字都是一样的,但顺序不一样也能导致意思大相径庭。这是为什么自然语言处理领域会用“序列”这个词,因为它表示一系列按照特定顺序排序的元素。前面提到,RNN 和人类阅读文本一样,对输入序列同样是按顺序依次处理,这就造成了训练速度的瓶颈,因为只能串行,没办法并行,也就是没法同时去学习所有信息。Transformer 把词输入给神经网络前,除了会先对词进行嵌入转换成向量,也就是把词用一串数字表示,它会把每个词在句子中的位置也各用一串数字表示,添加到输入序列的表示中,然后把这个结果给神经网络。这样模型既可以理解每个词的意义,又能够捕获词在句子中的位置,从而理解不同词之间的顺序关系。借助位置编码,可以不按顺序输入给 Transformer 模型,可以同时处理输入序列里的所有位置,而不需要像 RNN 那样依次处理。那么在计算时,每个输出都可以独立地计算,不需要等待其他位置的计算,这就大大提高了训练速度。训练速度一快,训练出巨大的模型也不是这么难了。位置编码,就是把表示各个词在文本里顺序的向量和上一步得到的词向量相加,然后把得到的结果传给编码器。这样做的意义是,模型既可以理解每个词的意义,又能够捕捉词在句子中的位置,从而理解不同词之间的顺序关系。
第四步:编码器。它的主要任务是把输入转换成一种更抽象的表示形式,这个表示形式也是向量表示的一串数字,里面既保留了输入文本的词汇信息和顺序关系,也捕捉了语法语义上的关键特征。捕捉关键特征的核心是编码器的自注意力机制。模型在处理每个词的时候,不仅会关注这个词本身和它附近的词,还会关注序列中所有其他词。正如 Transformer 论文标题所说,自注意力机制通过计算每对词之间的相关性,来决定注意力权重。实际上执行中,Transformer 使用了多头注意力机制,也就是编码器不只有一个注意力机制模块,每个头都有它自己的注意力权重,用来关注文本里不同特征或方面,比如有的关注动词,有的关注修饰词,有的关注情感,有的关注病理实体等等。而且它们之间可以做并行运算,也就是计算进展上互不影响。举例:我们想测试部门中谁的关系最近,先对部门中的每个成员进行个体画像,再总结关系最近的人是谁。这个可以分组进行,第一组(第一个头)按照个人信息进行关联,第二组(第二个头)按照大家的项目经验关联,第三组(第三个头)按照个人职业规划进行关联;通过多组并行打分操作,可以很快发现个体之间的关系。每个自注意力头的权重,都是模型在之前的训练过程中,通过大量文本逐渐学习和调整的。在多头注意力机制后面,还有一个前馈神经网络,它会对输出进行进一步增强表达能力。
第五步:解码器。它是大语言模型生成一个个词的关键。通过前面的编码器,我们有了输入序列里各个 token 的抽象表示,可以把它传给解码器。解码器还会先接收一个特殊值,这个值表示输出序列的开头。这样做的原因是,解码器不仅会把来自编码器的输入序列的抽象表示作为输入,还会把之前已经生成的内容作为输入,以保持输出的连贯性和上下文相关性。刚开始,还没有任何已生成的文本,所以把表示开头的特殊值先作为输入。具体的生成过程仍然要经过多个步骤。首先和编码器一样,文本要经过我们已经了解过的嵌入层和位置编码,然后被输入进多头自注意力层,但它和编码器里的多头自注意力层却不一样。当编码器在处理各个词的时候,它会关注输入序列里所有其他词,但解码器中的自注意力机制只会关注这个词和它前面的其他词,后面的词要被遮住而不去关注。这样做是为了确保解码器生成文本时遵循正确的时间顺序,不能先让它偷看后面的词,在预测下一个词时,只是用前面的词作为上下文。这种类型的多头注意力机制被叫做带掩码的多头注意力机制。另外的一个注意力机制,会捕捉编码器的输出和解码器即将生成的输出之间的对应关系,从而将原始输入序列的信息融合到输出序列的生成过程中。解码器里的前馈神经网络作用和编码器里的类似,也是通过额外的计算,来增强模型的表达能力。最后,和编码器一样,解码器同样是多个堆叠到一起的,这可以增加模型的性能,有助于处理复杂的输入输出关系。解码器的最后阶段,包含了一个线性层和一个 Softmax 层,它们加在一起的作用是,把解码器输出的表示转化为词汇表的概率分布,这个词汇表的概率分布代表下一个被生成 token 的概率。一般来说,模型会选择概率最高的 token 作为下一个输出。因此,解码器就是预测下一个输出的 token,和 GPT 的功能类似。
2、MoE 架构
自 2017 年 Google 提出 Transformer 架构以来,其“注意力机制 + 全连接层”的设计成为 LLM 的标准范式。但随着模型规模从 BERT(3.4 亿参数)增长至 GPT-4(1.8 万亿参数),传统密集架构逐渐暴露三大核心问题:
- 计算复杂度高:注意力机制的时间复杂度为 O(n²)(n 为序列长度),长文本处理时显存占用呈二次方增长。
- 参数利用率低:无论输入任务类型(如文本生成、数学推理、代码分析),模型所有参数均被激活,导致 90% 以上的计算资源浪费在非关键任务上。
- 训练成本高昂:GPT-4 训练消耗约 2.15e25 FLOPs(浮点运算次数),需动用上万张 A100 GPU,仅少数科技巨头能负担。
可以看出,在大语言模型(LLM)爆发式发展的今天,模型规模与计算效率的矛盾日益凸显。传统 Transformer 架构采用全参数激活模式,导致计算资源与参数规模呈线性正相关。以 GPT-3 为例,1750 亿参数意味着每次前向传播都需要调动全部计算资源,这种“全员在线”模式在参数突破万亿后将面临算力消耗呈指数级增长、推理延迟居高不下、边缘设备部署困难等瓶颈。
在此背景下,DeepSeek 作为中国本土自主研发的新一代大模型,以“稀疏激活 + 动态路由”为核心设计理念,通过混合专家(Mixture-of-Experts, MoE)架构实现了“万亿参数规模与高效推理”的平衡,其 6710 亿参数模型单次推理仅激活 370 亿参数(约 5.5%),在保持性能领先的同时将计算成本降低至传统模型的 1/11。这款采用混合专家架构的模型,不仅在参数数量上实现量级跨越,更通过动态路由机制重构了 AI 计算范式。
MoE(Mixture of Experts)是一种深度学习架构,旨在通过多个专家模型和一个门控网络的组合来处理复杂任务。其核心思想是将输入数据分配给不同的专家,以提高模型的效率和性能。
MoE 层通常嵌入在 Transformer 块中以替代标准的前馈网络(FFN)层,其主要由以下部分构成:
- 专家网络(Experts):是一组并行的、结构相同的神经网络。在 Transformer 中,每个专家就是一个两层的多层感知机(MLP)。它们的结构一样,但权重参数是独立训练、互不共享的。
- 门控网络(Gating Network):是一个小型的神经网络,通常是一个简单的线性层加上一个 Softmax 激活函数。它接收来自上一层的 token 隐藏状态作为输入,输出一个覆盖所有专家的概率分布。这个分布表明了每个专家处理当前 token 的“适合度”。
- 路由策略(Routing Strategy):门控网络输出概率后,系统根据预设的策略选择激活哪些专家。最常见的策略是“Top-k”,即选择概率最高的 k 个专家。输入 token 的向量会乘以其对应的门控权重,然后被送入选定的专家中进行计算。最后,所有被激活专家的输出会根据门控权重加权求和,形成该 MoE 层的最终输出。
MoE 架构通过引入专家网络(Expert Networks)和门控机制(Gating Network),实现了参数规模与计算资源的解耦。DeepSeek-V3 采用 128 个专家模块,每个专家包含 80 亿参数,总参数规模达 1.024 万亿,但单次推理仅激活 2% 的专家(约 200 亿参数),计算效率提升 5 倍以上。
在经典 MoE 基础上,DeepSeek-V3 引入三层动态路由机制:
- 输入特征分层:将输入向量分解为语义特征、时序特征和领域特征。
- 专家分组策略:将 128 个专家划分为 16 个专业组(每组 8 个专家)。
- 渐进式路由:首轮全局路由确定专业组,次轮组内路由选择具体专家。
这种设计使模型在保持万亿参数规模的同时,实现了 98.7% 的专家利用率(传统 MoE 架构通常低于 85%)。
五、微调与对齐
微调(Fine-Tuning)是深度学习领域中一种高效的模型优化技术,其核心在于利用预训练模型(Pre-trained Model)作为起点,通过少量目标任务数据对模型参数进行针对性调整。与从零开始训练(Training from Scratch)相比,微调能显著降低计算成本(通常减少 50%—90% 的训练时间)和数据需求(可仅用 1/10 的数据达到同等精度),尤其适用于数据稀缺或计算资源有限的场景。
1、指令微调(Instruction Tuning)
指令微调(Instruction Tuning)又称有监督微调(Supervised Fine-tuning)。通过指令微调,大语言模型能够更好地学习遵循和执行人类指令。
指令微调具体训练过程并不复杂,主要分为如下三个步骤:
- 针对每一项任务去明确地定义相应的自然语言形式的指令或者提示,这些指令或提示对任务目标以及输出要求进行清晰描述;
- 把训练数据调整成包含指令以及与之对应的响应的形式;
- 使用包含指令和响应的训练数据对预训练模型进行微调操作。从训练方式的角度来看,指令微调与预训练大体上较为相似,不过指令微调的目标函数往往只是针对输出部分来计算损失。
指令数据集对于指令微调非常重要,无论手工还是自动构建都需要花费一定的时间和成本。目前已经有一些开源指令数据集,本节将选择一些常用的指令数据集进行介绍。如果按照类型来划分,指令微调数据集可以分为两大类:通用指令微调数据集(General Instruction Fine-tuning Datasets)和特定领域指令微调数据集(Domain-specific Instruction Fine-tuning Datasets)。通用指令微调数据集涵盖了各种跨领域指令,旨在提高模型在通用任务上的效果以及指令遵循能力。特定领域指令微调数据集中的指令是专门为特定领域设计的,例如,法律领域指令集包含法律考试、法律咨询、法律问答等任务的指令数据。
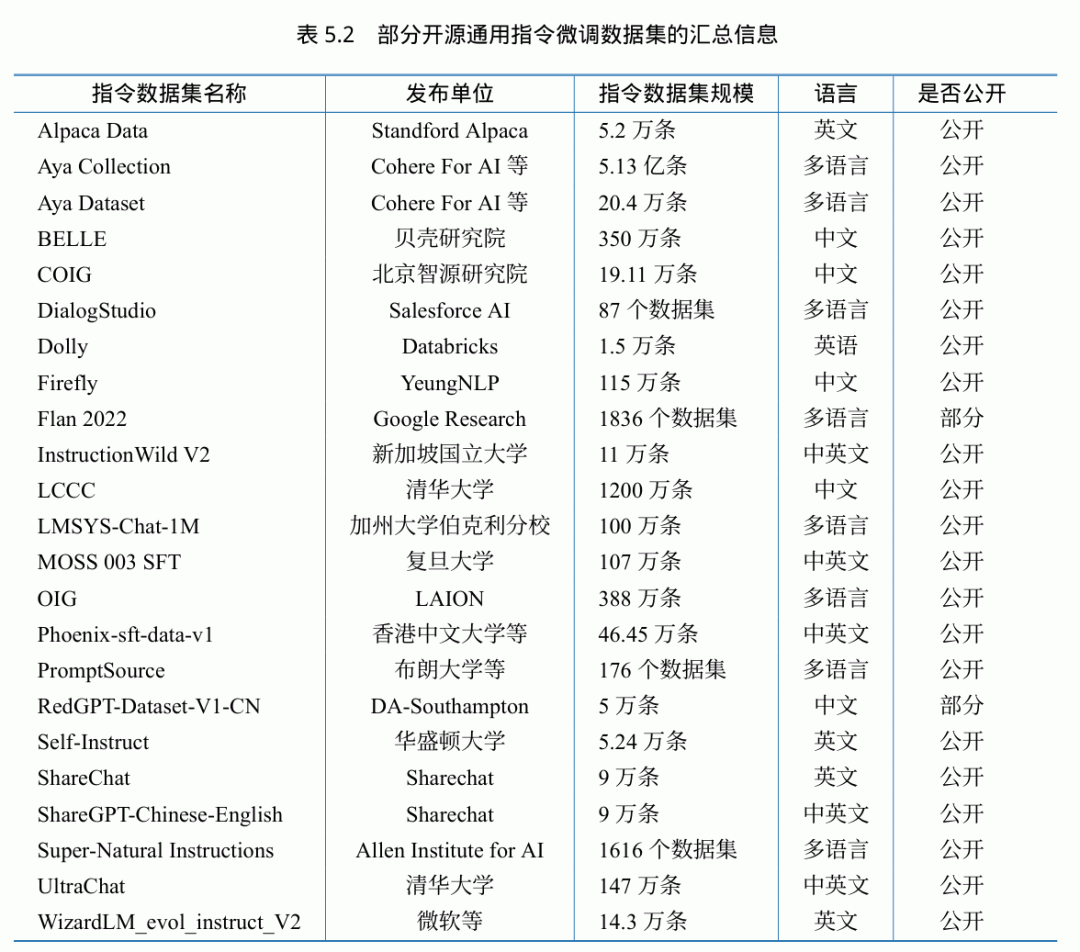
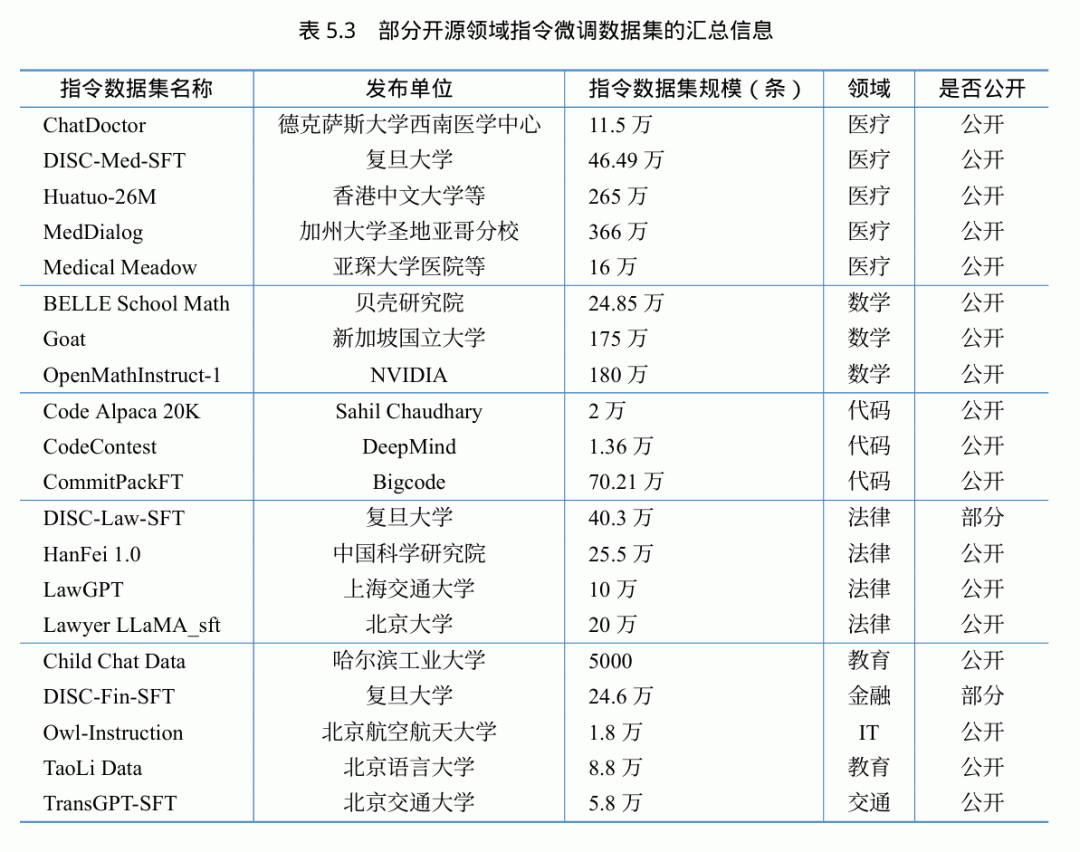
由于大语言模型的参数量十分庞大,当将其应用到下游任务时,微调全部参数需要相当高的算力。为了节省成本,研究人员提出了多种参数高效(Parameter-Efficient)的微调方法,旨在仅训练少量参数就使模型适应下游任务。
参数高效微调(Parameter-Efficient Fine-Tuning, PEFT)
参数高效微调旨在避免微调全部参数,减少在微调过程中需要更新的参数数量和计算开销,从而提高微调大语言模型的效率。主流的 PEFT 方法可以分为三类:参数附加方法(Additional Parameters Methods)、参数选择方法(Parameter Selection Methods)以及低秩适配方法(Low Rank Adaptation Methods)。
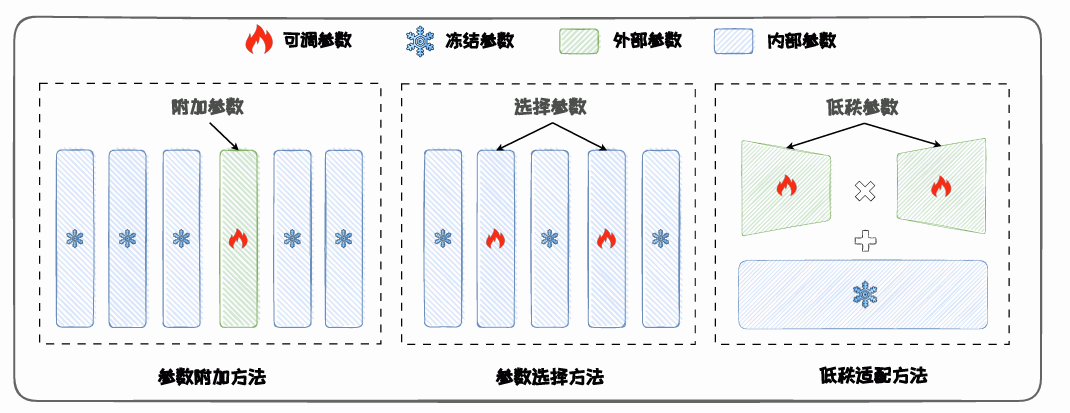
以 LoRA(Low-Rank Adaptation of Large Language Models,大语言模型的低秩适配器)为例,介绍高效模型微调方法。LoRA 方法可以在缩减训练参数量和 GPU 显存占用的同时,使训练后的模型具有与全量微调相当的性能。
该方法将参数更新矩阵低秩分解为两个小矩阵。在微调时,通过微调这两个小矩阵来对大语言模型进行更新,大幅节省了微调时的内存开销。
文献提供在 LLaMA2-7B 模型上使用批量大小为 1、单个 NVIDIA RTX 4090(24GB)GPU 上进行全量微调和 LoRA 微调的实验对比。根据实验结果,全量微调大约需要 60GB 显存,超出 RTX 4090 的显存容量;相比之下,LoRA 只需要大约 23GB 显存。LoRA 显著减少了显存使用,使得在单个 NVIDIA RTX 4090 上进行 LLaMA2-7B 微调成为可能。具体来说,由于可训练参数较少,优化器内存和梯度内存分别减少了约 25GB 和 14GB。另外,虽然 LoRA 引入了额外的“增量参数”,导致激活内存和权重内存略微增加(总计约 2GB),但考虑到整体内存的减少,这种增加是可以忽略不计的。此外,减少涉及到的参数计算可以加速反向传播。与全量微调相比,LoRA 的速度提高了 1.9 倍。
2、人类对齐(Human Alignment)
尽管大语言模型在下游任务中表现出优秀的性能,这些模型有时会出现错误或具有危害性的行为,例如无法正确遵循指令、生成虚假信息,以及产生有害、有误导性、带有偏见的表达。在大语言模型的预训练和有监督微调的过程中,主要训练目标是根据上下文内容来预测下一个词元。但是,这一过程并未充分考虑人类的价值观或偏好,可能导致大语言模型从数据中学习到不符合人类期望的生成模式。为了规避这些潜在风险,研究人员提出了“人类对齐”这一关键概念,旨在保证大语言模型的行为符合人类期望和价值观。与预训练和指令微调不同,人类对齐需引入全新的评估标准,如有用性、诚实性和无害性。
在大语言模型的学习过程中,如何确保大语言模型的行为与人类价值观、人类真实意图和社会伦理相一致,成为了一个关键研究问题,通常称这一研究问题为人类对齐(Human Alignment)。
实现人类对齐的关键技术是基于人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF),包括人类反馈的收集方法、奖励模型的训练过程、强化学习训练策略以及相关的 RLHF 工作。
基于人类反馈的强化学习(RLHF)
当前大语言模型中的强化学习技术主要沿着两个方向演进:其一是基于人类反馈的强化学习(RLHF),通过奖励模型对生成文本进行整体质量评估,使模型能自主探索更优的回复策略,并使得模型回复与人类偏好和价值观对齐。典型如 ChatGPT 等对话系统,通过人类偏好数据训练奖励模型,结合近端策略优化(Proximal Policy Optimization,PPO)算法实现对齐优化。其二是面向深度推理的强化学习框架,以 OpenAI 的 o 系列模型和 DeepSeek 的 R 系列为代表,通过答案校验引导模型进行多步推理。这类方法将复杂问题分解为长思维链(Chain-of-Thought)的决策序列,在数学证明、代码生成等场景中展现出超越监督学习的推理能力。
相较于传统监督学习,强化学习框架具有显著优势:在 RLHF 范式下,模型通过生成—反馈的闭环机制持续优化,摆脱对标准答案的绝对依赖;在深度推理场景中,强化学习能自主探索最优推理路径,通过价值函数估计引导模型突破局部最优解。两类方法都强调对生成文本的整体质量把控,前者侧重人类价值对齐,后者专注复杂问题求解,共同构成大语言模型能力进化的核心驱动力。
RLHF 算法系统主要包括三个关键组成部分:需要与人类价值观对齐的模型、基于人类反馈数据学习的奖励模型,以及用于训练大语言模型的强化学习算法。
- 待对齐模型一般指的是经过预训练、具备一定通用能力的大语言模型。然而,这些模型并没有与人类价值观对齐,在下游任务中可能表现出不合适甚至有害的行为。
- 奖励模型既可以采用人类偏好数据对已有的语言模型继续微调,也可以基于人类偏好数据重新训练一个新的语言模型。
- 强化学习算法:在训练过程中,基于奖励模型提供的反馈信号,RLHF 使用特定的强化学习算法进行大语言模型的训练。目前,PPO 算法是一种被广泛用于人类对齐的强化学习算法。
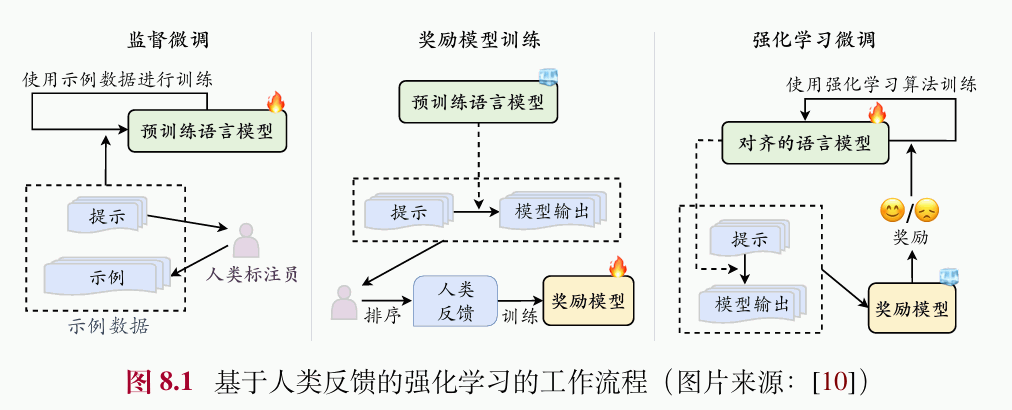
图 8.1 展示了 RLHF 整体训练框架的三个阶段,下面分阶段进行具体介绍。
- 监督微调:为了让待对齐语言模型具有较好的指令遵循能力,通常需要收集高质量的指令数据进行监督微调。指令数据一般包括任务描述和示例输出,可以由人类标注员针对特定任务编写,也可以由大语言模型自动生成。在 InstructGPT 中,人类标注员为多个生成任务(如开放性问答、头脑风暴、日常聊天等)编写提示和相应的示例输出(例如“列出五种恢复职业热情的方法”)。
- 奖励模型训练:第二步是使用人类反馈数据训练奖励模型。具体来说,首先使用语言模型针对任务指令生成一定数量的候选输出。随后,邀请标注员对于输出文本进行偏好标注,这个标注过程可以采用多种形式,其中最常用的是对候选文本进行排序标注,这样可以有效减少多个标注员之间的不一致情况。进一步,使用人工标注的偏好数据进行奖励模型的训练,使其能够建模人类偏好。在 InstructGPT 中,标注员将模型生成的输出按照最佳到最差的顺序进行排序,并据此训练奖励模型来预测这个排序。
- 强化学习训练:在这一步骤中,语言模型对齐被转化为一个强化学习问题。具体来说,待对齐语言模型担任策略实施者的角色(称为策略模型),它接收提示作为输入并返回输出文本,其动作空间是词汇表中的所有词元,状态指的是当前已生成的词元序列。奖励模型则根据当前语言模型的状态提供相应的奖励分数,用于指导策略模型的优化。为了避免当前训练轮次的语言模型明显偏离初始(强化学习训练之前)的语言模型,通常会在原始优化目标中加入一个惩罚项(如 KL 散度)。例如,InstructGPT 使用 PPO 算法来优化待对齐语言模型以最大化奖励模型的奖励。对于每个输入提示,InstructGPT 计算当前语言模型与初始语言模型生成结果之间的 KL 散度作为惩罚项。KL 散度越大,意味着当前语言模型越偏离初始语言模型。这个对齐过程可以进行多次迭代,从而更好地对齐大语言模型。
人类反馈数据的收集
为了实现有效的人类对齐,需要使用高质量的人类反馈数据对大语言模型进行针对性的微调。
标注人员选择
为了确保人类反馈数据的可靠性,选择合适的标注人员至关重要。一般来说,理想的标注员应具备较高的教育水平以及出色的语言熟练度。例如,Sparrow 要求标注员必须是英国本土的英语母语者,并至少具备本科及以上学历。尽管如此,研究人员与标注员之间仍然可能存在意图不匹配的情况,这可能导致生成不一致的反馈数据,进而影响模型的输出。为了解决这一问题,InstructGPT 通过对标注员与研究人员之间的标注一致性进行评估来筛选出合适的标注员。具体来说,研究人员首先标注一小部分数据,然后邀请候选标注员进行标注,并计算候选标注员与研究人员标注结果之间的一致性分数。最终,只选择一致性分数较高的标注员进行后续的标注工作。此外,还可以从一组表现较好的标注员中选出高度一致的“超级标注员”,这些超级标注员将优先与研究人员合作进行后续研究。此外,在标注过程中,提供详细的标注说明和即时指导有助于进一步规范标注员的标注行为。
人类反馈的形式
确定标注人员的选择后,可以对大语言模型的输出进行标注,以收集人类反馈数据。
- 基于评分的人类反馈:最直接的标注方式是根据预设的标准邀请标注人员对大语言模型的输出进行打分,从而作为模型输出质量的判断。
- 基于排序的人类反馈:排序是一种比较典型的人类偏好标注形式。最简单的方式是标注人员根据自身偏好对大语言模型的输出进行全排序。
奖励模型的训练
由于 RLHF 的训练过程中需要依赖大量的人类偏好数据进行学习,因此很难在训练过程中要求人类标注者实时提供偏好反馈。为此,我们需要训练一个模型来替代人类在 RLHF 训练过程中实时提供反馈,这个模型被称为奖励模型。
在训练开始前,我们需要预先构造一系列相关问题作为输入。人类标注者将针对这些问题标注出符合人类偏好的输出以及不符合人类偏好的输出。收集到这些人类偏好数据后,就可以用来训练奖励模型。经过充分训练的奖励模型能够有效地拟合人类偏好,并在后续的强化学习训练过程中替代人类提供反馈信号。这样一来,就可以在保证训练效率的同时,加强模型行为与人类期望的一致性。
强化学习训练
强化学习是 RLHF 中的核心优化算法。一般来说,强化学习旨在训练一个智能体,该智能体与外部环境进行多轮交互,通过学习合适的策略进而最大化从外部环境获得的奖励。在强化学习的过程中,智能体是根据外部环境决定下一步行动的决策者,因此其被称为策略模型。
近端策略优化(Proximal Policy Optimization, PPO)算法是强化学习领域的一种重要优化方法,主要用于训练能够根据外部环境状态做出行为决策的策略模型。PPO 算法在策略梯度算法的基础上,主要使用优势估计来更加准确地评估决策轨迹能获得的奖励,并使用重要性采样来进行离线策略训练。此外,为了保证重要性采样的稳定性,PPO 算法通过在目标函数中加入梯度裁剪以及相关的惩罚项来减小采样误差。
代表性 RLHF 大模型
InstructGPT 模型使用 RLHF 方法,在自监督文本数据预训练的基础上,结合了人类反馈与强化学习,从而能够构建更符合人类价值观的模型。
InstructGPT 模型的训练过程主要包括三个关键步骤。首先,需要收集指令数据并使用有监督微调进行训练。OpenAI 的研究团队雇佣了 40 名标注人员,针对给定任务提示编写对应的输出示例。这些数据将用于经过预训练后的 GPT-3 模型的监督微调。然后,收集人类反馈数据训练奖励模型。标注人员对于模型生成的输出进行对比与排序,然后训练奖励模型来拟合标注人员的偏好。最后,使用 PPO 算法和奖励模型进行大语言模型的强化学习训练。在这个步骤中,使用第二步训练得到的奖励模型,对于第一步监督训练得到的语言模型进行微调,从而实现人类价值观的对齐。后两个步骤可以迭代多次,基于当前最佳的语言模型持续收集数据,进一步训练奖励模型和优化模型的生成策略。
实验结果表明,即使参数量仅为 1.3B 的 InstructGPT 模型,在相关评测任务上性能也超过了高达 175B 参数的 GPT-3 模型。InstructGPT 在生成内容的诚实性、减少有害输出方面表现更优,同时在公开的自然语言处理数据集上的表现没有明显下降,所带来的“对齐税”(Alignment Tax)并不是很高。
关于 SFT 和 RLHF
总体来说,RLHF 和 SFT 可以被视为两种优化大语言模型决策过程的训练方法。在 RLHF 中,我们首先学习一个奖励模型,然后利用该奖励模型通过强化学习算法(如 PPO)来改进大语言模型。而在 SFT 中,我们则采用了 Teacher-Forcing 的方法,直接优化模型对实例输出的预测概率。从本质上说,SFT 所采用的这种词元级别的训练方式是一种“行为克隆”,它利用教师的行为数据(即每个步骤的目标词元)作为监督标签,来直接训练大语言模型模仿教师的行为。在实现上,SFT 主要依赖于序列到序列的监督损失来优化模型,而 RLHF 则主要通过强化学习方法来实现大模型与人类价值观的对齐。本质上来说,为了学习教师的生成策略,SFT 采用了基于示例数据的“局部”优化方式,即词元级别的损失函数。作为对比,RLHF 则采用了涉及人类偏好的“全局”优化方式,即文本级别的损失函数。
SFT 已经成为一种主要的大语言模型微调方法,能够显著提升大语言模型在各种基准测试中的性能,增强在不同任务上的泛化能力。关于 SFT,人们普遍认为其作用在于“解锁”大语言模型的能力,而非向大语言模型“注入”新能力。因此,试图通过 SFT 激发大语言模型的非内生能力时,可能会出现一些负面问题。当待学习的标注指令数据超出了大语言模型的知识或能力范围,例如训练大语言模型回答关于模型未知事实的问题时,可能会加重模型的幻象(Hallucination)行为。OpenAI 强化学习研究团队的负责人、PPO 算法的作者 John Schulman 在一场关于 RLHF 的讲座中提出了一个有趣的观点:通过蒸馏较大模型来训练较小模型可能会增加模型生成幻觉文本的可能性,从而可能影响大语言模型的事实准确性。实际上,目前无论学术界和工业界都在大量使用 GPT-4 进行指令微调数据的蒸馏,在这一过程中除了要考虑指令数据本身的质量外,还需要进一步关注模型自身的知识与能力边界,从而减少微调过程中所产生的负面效应,如上述提到的幻象问题。此外,作为一种基于行为克隆的学习方法,SFT 旨在模仿构建标注数据的教师的行为,而无法在这一过程中进行有效的行为探索。然而,标注者在写作风格、创作水平和主题偏好等方面经常存在一定的差异,这些都会使得标注数据中出现不一致的数据特征,进而影响 SFT 的学习性能。因此,在 SFT 阶段,高质量的指令数据(而非数量)是影响大语言模型训练的主要因素。
最初,RLHF 是在深度强化学习的文献中被提出,随后被借鉴用于提升语言模型的能力。在早期的研究中,研究人员主要关注使用 RLHF 加强模型对于人类价值观的遵循,减少模型输出的有害性。在最近的研究中,相关研究发现 RLHF 在减少有害内容输出的同时,也能够有效增强模型的综合能力,这一点在 LLaMA-2 的论文中有着充分讨论。在 RLHF 算法中,标注员主要为训练过程提供偏好标注数据,而不是直接生成示例数据,因此它可以减少标注员之间的不一致。其次,与编写示例数据相比,偏好标注更为简单易行。标注员甚至可以评估超出自己创作水平的模型输出质量,使得模型能够探索标注员能力之外的状态空间,而不用受限于给定的教师示例。上述两个方面都使得 RLHF 在数据标注阶段相比 SFT 更加具有优势,更加容易充分发挥人类指导的作用。在模型学习阶段,RLHF 通过对比模型的输出数据(区分“好”输出与“坏”输出)来指导大语言模型学习正确的生成策略,它不再强迫大语言模型模仿教师的示例数据,因此可以缓解上述提到的 SFT 所导致的幻象问题。在 RLHF 方法中,奖励模型非常重要。一般来说,奖励模型应该能够了解待对齐的大语言模型的知识或能力范畴。然而,RLHF 也继承了经典强化学习算法的缺点,如样本学习效率低和训练过程不稳定等问题。因此,当训练语言模型时,RLHF 需要依赖于经过 SFT 的模型作为策略模型的初始模型,从而快速达到较好的表现。这也是 InstructGPT 采用 SFT 作为 RLHF 方法第一步的主要原因。此外,RLHF 的过程通常会持续多轮,这是一个复杂的迭代优化过程,其中涉及了很多重要细节的设定(例如提示选择、奖励模型训练、PPO 的超参数设置以及训练过程中对超参数的调整),都会影响整个模型的性能,对于精确的高效复现提出了较大挑战。
总的来说,SFT 特别适合预训练后增强模型的性能,具有实现简单、快速高效等优点;而 RLHF 可在此基础上规避可能的有害行为并进一步提高模型性能,但是实现较为困难,不易进行高效优化。未来的研究仍然需要探索更为有效的对齐方法,同时结合 SFT 与 RLHF 的优点。此外,还需要关注当模型能力达到较强水平后更为有效的对齐方法。针对这个问题,OpenAI 提出了“超级对齐”(Super-alignment)这一研究方向,旨在能够有效监管具有超级智能的人工智能系统。
让仓储与产线物流先一步智能化
告诉我们您的仓库形态、物料类型与产能目标,方案顾问会给出可落地的自动化路径。