无锡市新吴区清晏路32号中电海康D2
400-9966-420
sales@tjlinker.com

别吹 RAG 了!本地知识库实测 SAG2 完胜,又快又准还便宜

才被嘲 RAG 多跳检索是死胡同,转头一个连 embedding 都不用的开源项目,把八项指标全刷到了第一。

2.36 秒11,656 段文本的建库耗时,在 M4 Pro Mac 上跑完
7000×相对 SAG 一代的建库提速,4.57 小时压缩到 2.36 秒
0 token建库阶段不调用任何模型,token 消耗为零
十几 MB整个知识库的体积,不需要向量数据库托管

一、RAG 好用,但多跳检索是死穴

RAG 这个词 2020 年就有了,真正火起来是 ChatGPT 之后。大模型不知道你公司的事,那就把资料切块转向量,提问时找最像的丢进去。后来加了全文检索、重排序,混合检索成了标配。单文档问答够用,一碰多跳就歇菜。

文档 1 说 A 公司收购了 B 公司,文档 2 说张三当了 A 公司 CTO,文档 3 说张三离职去了盘古大模型项目。问:收购 B 公司的企业,其 CTO 后来去了哪?文档 3 里一个相关词都没有,线索直接断。

二、图谱方案:多跳强了,代价是烧 token

于是有了 GraphRAG、LightRAG、HippoRAG 2 这些图谱方案。入库前让大模型把实体关系全抽出来画大图,多跳强了,代价是索引阶段烧大量 token,新文件进来还得重算。每往前走一步,都在用钱和算力换准确率。
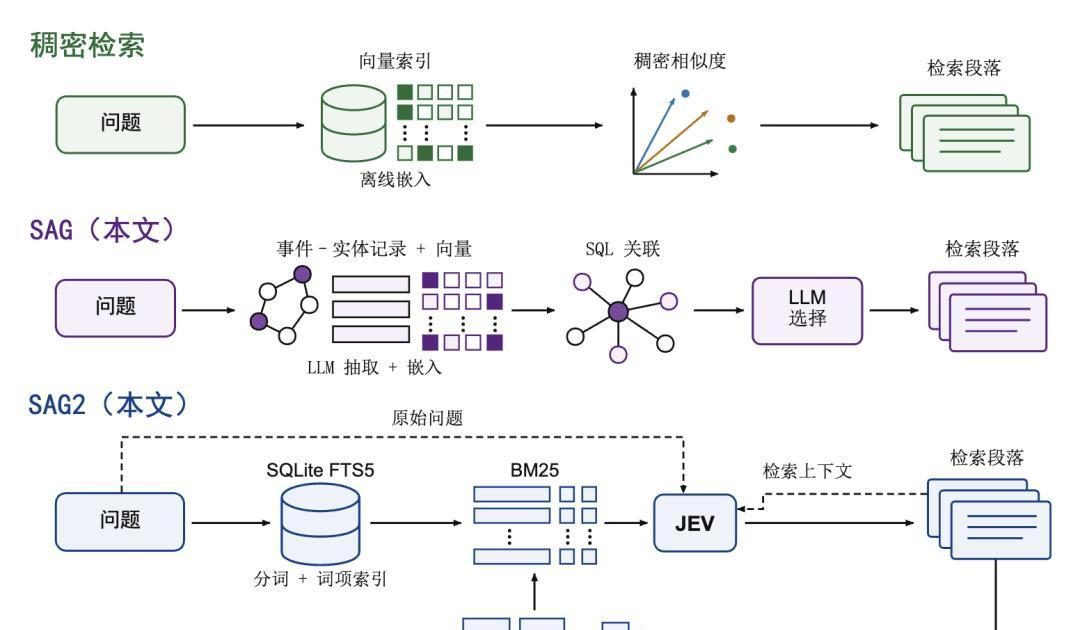
三条检索路线对比:稠密检索经向量索引与相似度取段落;SAG 用事件实体记录加 SQL 关联再由大模型选择;SAG2 用 SQLite FTS5 分词建索引、BM25 取候选、JEV 判断相关性
三种检索路线:稠密检索靠向量相似度,SAG 靠实体关系图谱,SAG2 回到分词索引加相关性判断

三、被低估的是维护成本

先说说我自己。2024 年初裸辞 All in AI,第一桶金就是帮老板搭 FastGPT、调知识库。搭库不难,难的是维护。分块切不好,张三负责 A 项目和 500 万预算被切成两段,线索就断了;score 调低噪音多,调高又漏东西,按下葫芦浮起瓢。有个朋友的公司,六人团队花了整整半年,才把准确率调到满意的状态。文件一改,又得重新上传、切块、向量化。这些坑,我全踩过。

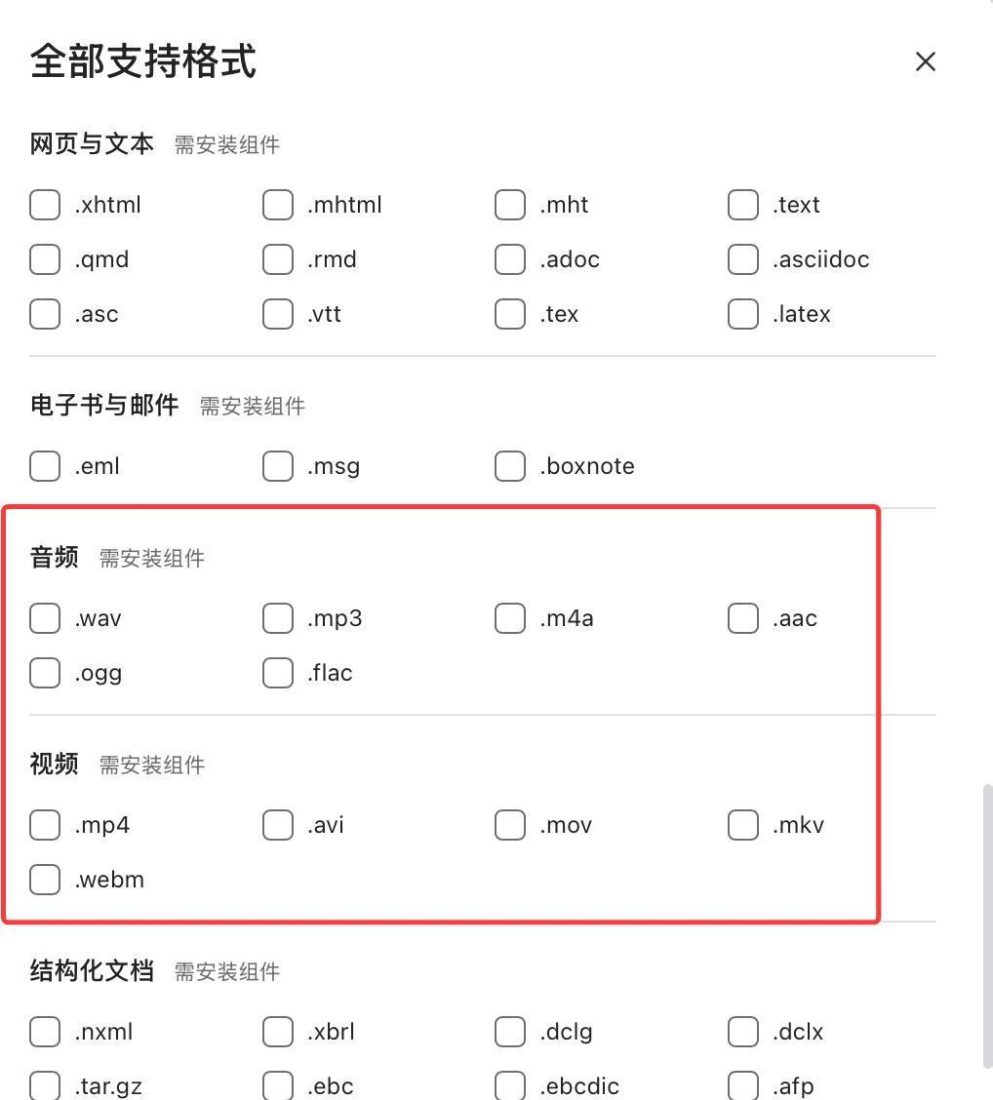
连文件格式这一关都不轻松。PDF、Word、PPT、Excel 各是一套解析,音视频还要单独装识别组件,格式越杂,前期准备越长。
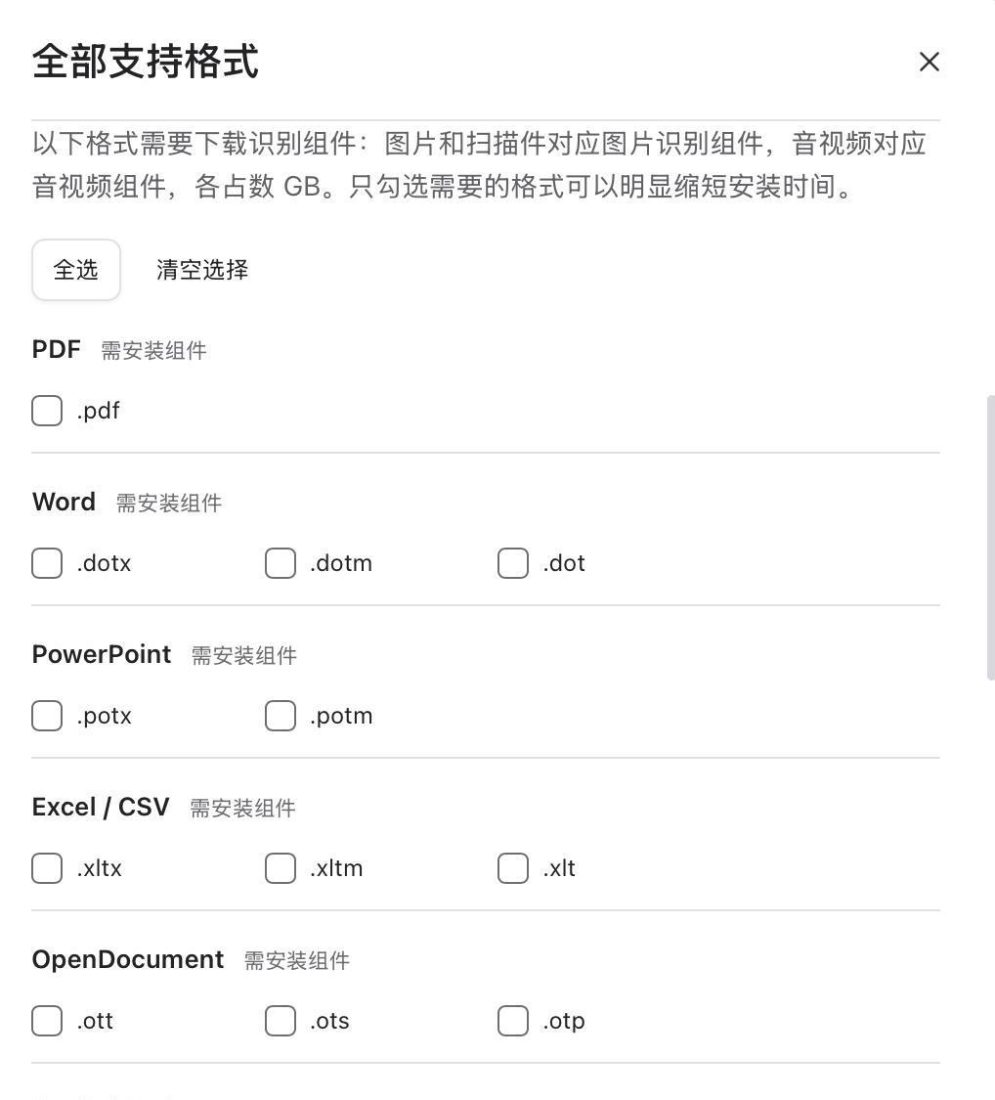
SAG Wiki「全部支持格式」面板上半部分,PDF、Word、PowerPoint、Excel/CSV、OpenDocument 各格式可勾选,均标注需安装识别组件
支持格式(一):PDF、Word、PowerPoint、Excel/CSV 按需勾选识别组件,只勾需要的能明显缩短安装时间
SAG Wiki「全部支持格式」面板下半部分,网页与文本、电子书与邮件、音频、视频、结构化文档等格式可选,音频与视频被红框标出
支持格式(二):网页文本、电子书、音视频等都要单独装组件——文件格式越杂,前期准备工作越多

四、SAG2:把预处理全砍了

说实话,AI 圈混久了,已经很少有东西能让我浑身起鸡皮疙瘩。但最近开源的 SAG2,真就做到了。不用预处理文件,不用向量数据库,不用 GPU,直接把本地文件当知识库用。关键是,又快又准又便宜。
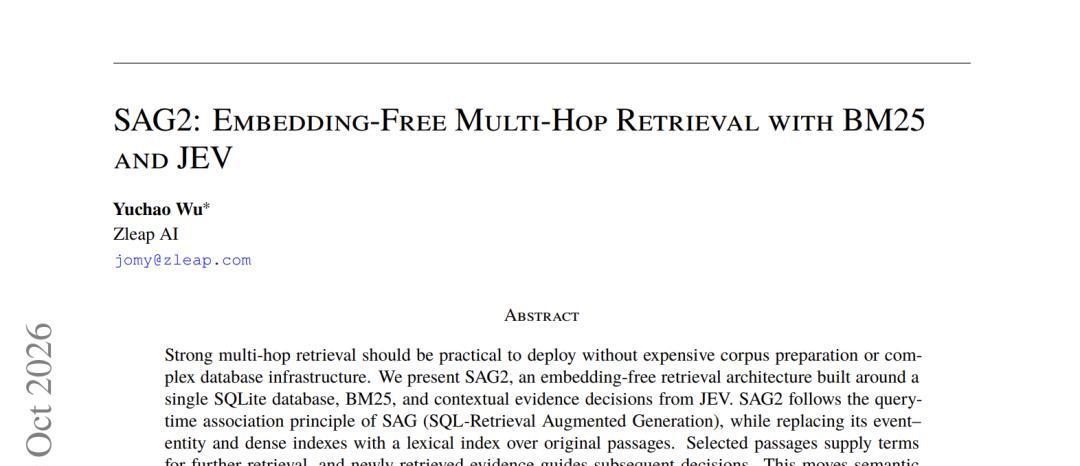
论文首页:SAG2: Embedding-Free Multi-Hop Retrieval with BM25 and JEV,作者 Yuchao Wu,Zleap AI,2026 年 10 月
论文《SAG2: Embedding-Free Multi-Hop Retrieval with BM25 and JEV》,作者 Yuchao Wu(Zleap AI)

SAG2 把这条路反过来了。建库阶段不调任何模型,就用 BM25 对原文建关键词索引。BM25?九十年代的老古董,Elasticsearch 默认打分就是它。一个刷新 SOTA 的方案,底座居然是个三十年前的老算法。同样是 11,656 段文本,SAG 一代建库 4.57 小时,烧掉 2826 万 token;SAG2 在 M4 Pro Mac 上跑完,2.36 秒,零 token 消耗。4.57 小时到 2.36 秒,整整 7000 倍,砸得人头皮发麻。看到这个数字,我脑子里只有一个念头:预处理全砍了,效果居然还涨了。
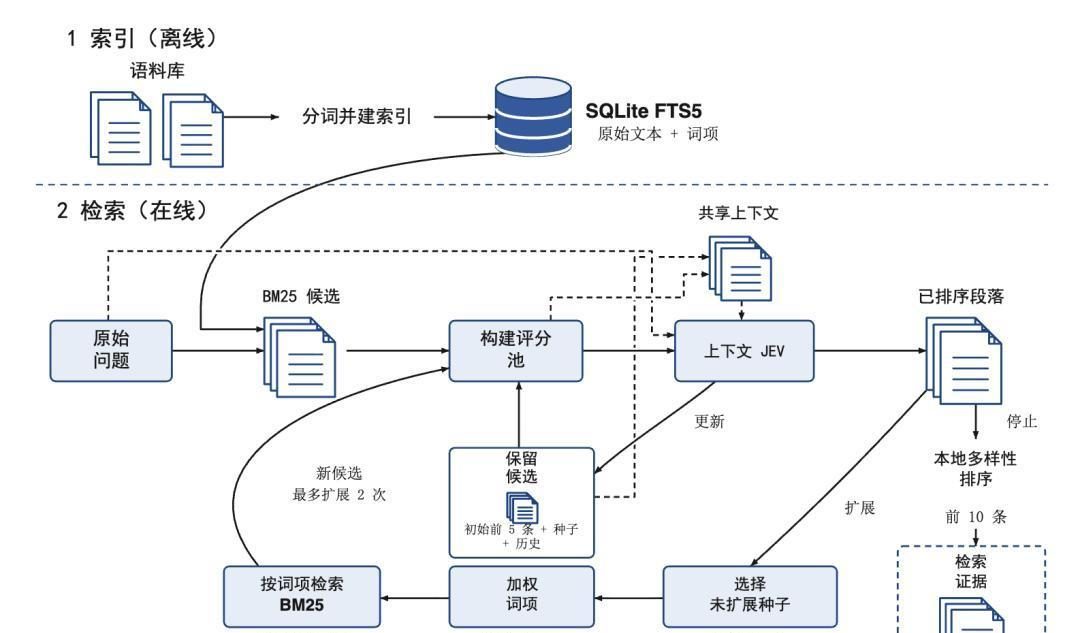
SAG2 两段式流程:离线索引阶段对语料库分词并写入 SQLite FTS5;在线检索阶段用 BM25 取候选、构建评分池、上下文 JEV 判断、本地多样性排序后输出前 10 条检索证据
SAG2 的两段式流程:离线只做分词建索引,在线靠 BM25 取候选、JEV 判断相关性
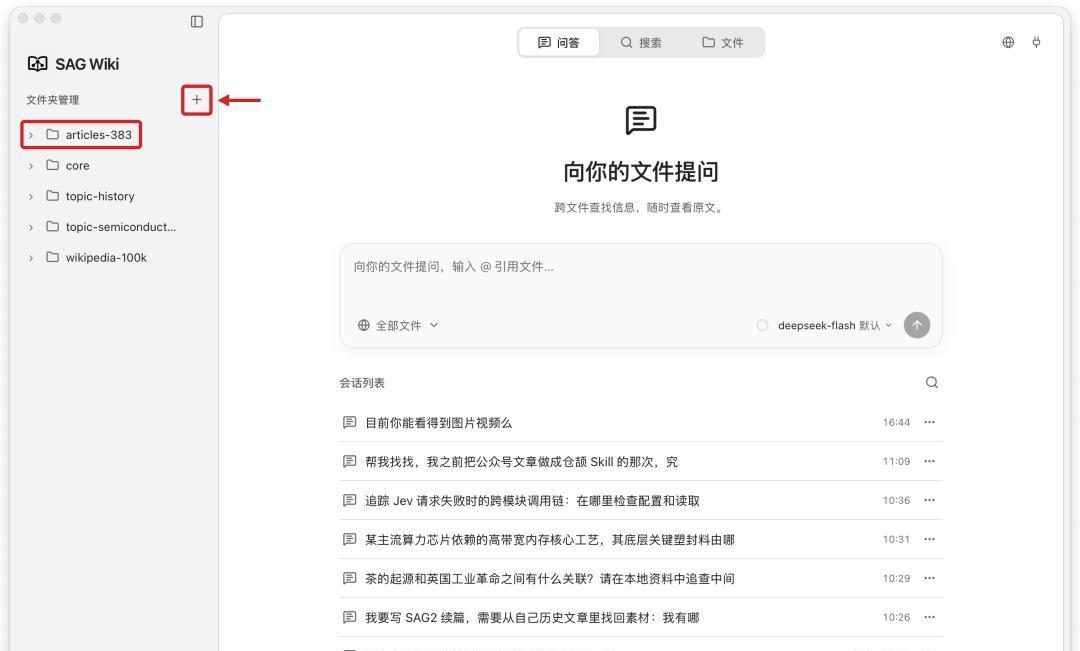
SAG Wiki 桌面端主界面,左侧是 articles-383、core、topic-history、wikipedia-100k 等文件夹,右侧是「向你的文件提问」输入框与会话列表
桌面端 SAG Wiki:左边管文件夹,右边直接向本地文件提问,检索记录留在本地

语义理解交给 JEV

语义理解靠 JEV,前 OpenAI 研究员发布的模型,不回文章,只给判断和打分,又快又便宜。流程是这样:BM25 粗筛候选,JEV 判断哪些有用,算法挑关键词继续搜,JEV 再结合已有证据判断新内容。

还是张三那例子,第一轮拿「收购、B 公司」搜到文档 1,JEV 判断有用;从文档 1 挑出「A 公司」再搜,命中文档 2,CTO 是张三;拿张三搜文档 3,盘古大模型项目出来了。线索全靠原文关键词串起来,压根不用提前抽实体。

五、实测:三个多跳测试集,八项指标第一

三个多跳测试集,八项指标全部第一。MuSiQue 上 Recall@5 达 80.68%,比 HippoRAG 2 高 15.55 个百分点。EnterpriseRAG-Bench 更狠,51 万份模拟企业文档,LightRAG、MS-GraphRAG、HippoRAG 2 全都没跑完全量,SAG2 全部跑完,建库 8 分 32 秒,Recall@10 达 81.10%。体积呢?十几 MB。
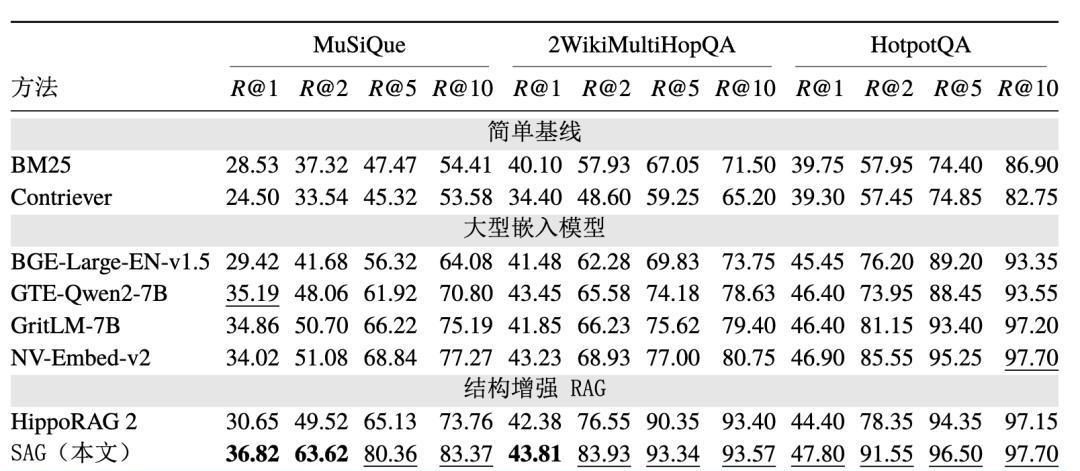
评测表:MuSiQue、2WikiMultiHopQA、HotpotQA 三个多跳数据集上各方法的 R@1、R@2、R@5、R@10,SAG 一栏为加粗的最优值
三个多跳测试集上的 Recall 对比:SAG 在绝大多数指标上加粗领先
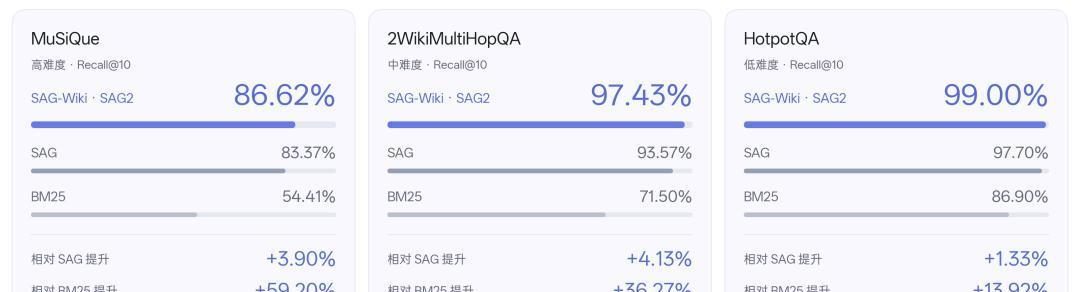
三张指标卡:MuSiQue Recall@10 为 86.62%、2WikiMultiHopQA 为 97.43%、HotpotQA 为 99.00%,相对 BM25 分别提升 59.20%、36.27%、13.92%
Recall@10 对比:三个数据集上 SAG-Wiki·SAG2 分别达到 86.62%、97.43%、99.00%

六、我自己也测了:五个真实场景

我自己也测了。把 383 篇历史文章扔进去,问之前蒸馏时处理了多少篇多少字,它翻了两次直接给出准确数字:138 篇、79 万字。
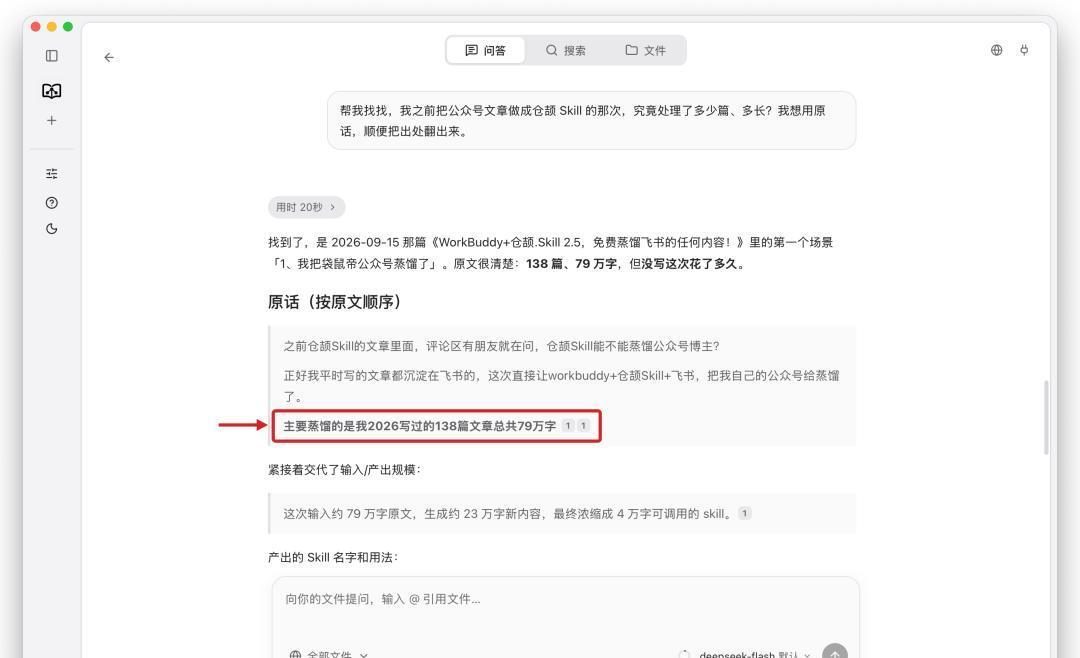
SAG Wiki 的回答截图:检索到 2026-09-15 那篇文章里的原话,红框标出「主要蒸馏的是我 2026 写过的 138 篇文章总共 79 万字」
问「之前蒸馏处理了多少篇多少字」,它翻了两轮给出准确数字:138 篇、79 万字,并把原文出处标出来

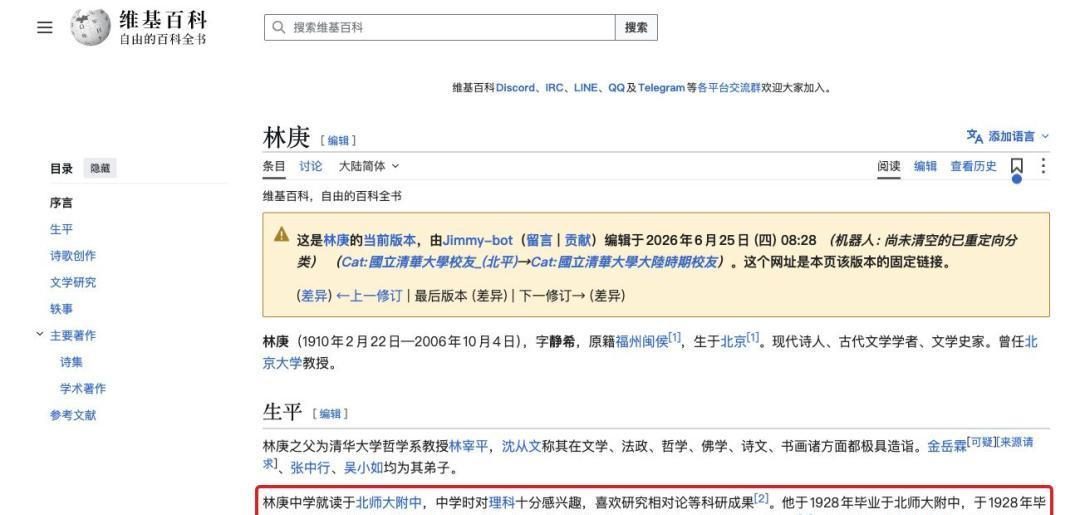
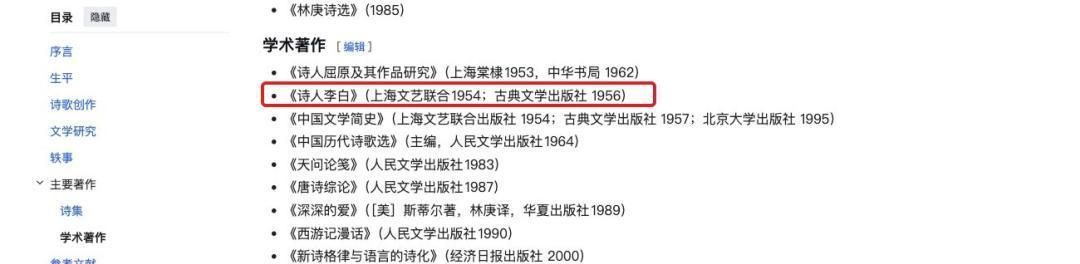
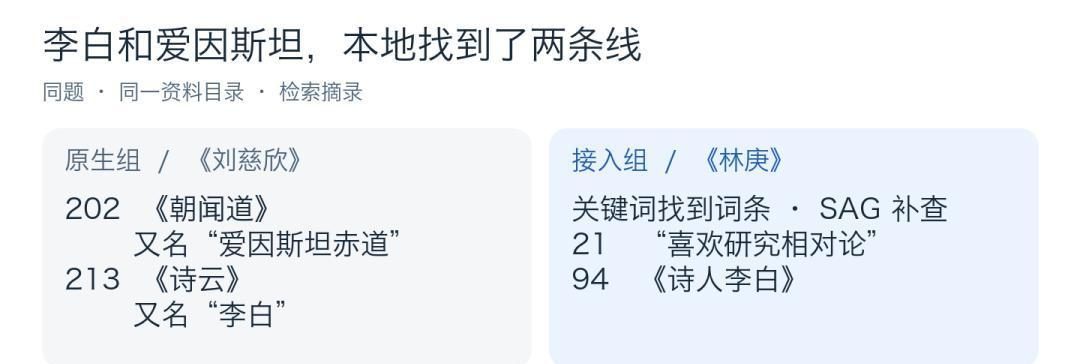
塞了 10 万篇维基词条,只给「李白」和「爱因斯坦」两个名字,要求每一步有出处。原生组翻到刘慈欣作品集,俩人在科幻里同框;接了 SAG2 的这边,定位到学者林庚——他年轻时在清华物理系痴迷相对论,后来写出了《诗人李白》。从相对论连到林庚,再连回李白,两头全是原文。
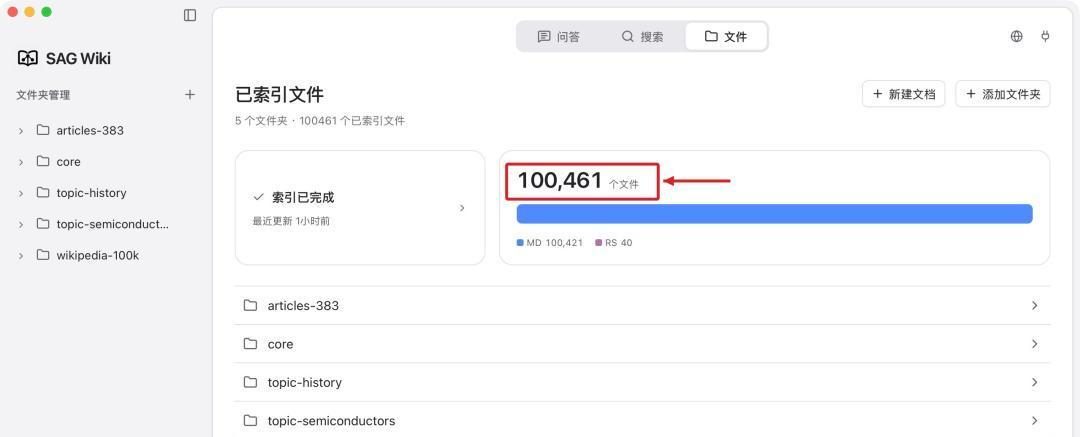
SAG Wiki 已索引文件面板:5 个文件夹、100,461 个已索引文件,其中 MD 100,421 个、RS 40 个
本地索引 10 万篇维基词条加 383 篇历史文章,合计 100,461 个文件
同一问题的两种检索结果:原生组在《刘慈欣》里找到《朝闻道》又名「爱因斯坦赤道」、《诗云》又名「李白」;接入组在《林庚》里找到「喜欢研究相对论」与《诗人李白》
只给「李白」和「爱因斯坦」两个名字:原生组在科幻作品里让两人同框,SAG2 走的是林庚这条史料链
维基百科「林庚」词条,红框标出「中学时对理科十分感兴趣,喜欢研究相对论等科研成果」一句
维基百科「林庚」词条:中学时喜欢研究相对论——这是从爱因斯坦连到李白的中间一跳
维基百科「林庚」词条的学术著作列表,红框标出《诗人李白》(上海文艺联合 1954;古典文学出版社 1956)
同一条目的学术著作列表:《诗人李白》正是这条证据链的落点

七、接进 Agent:少翻几次文件

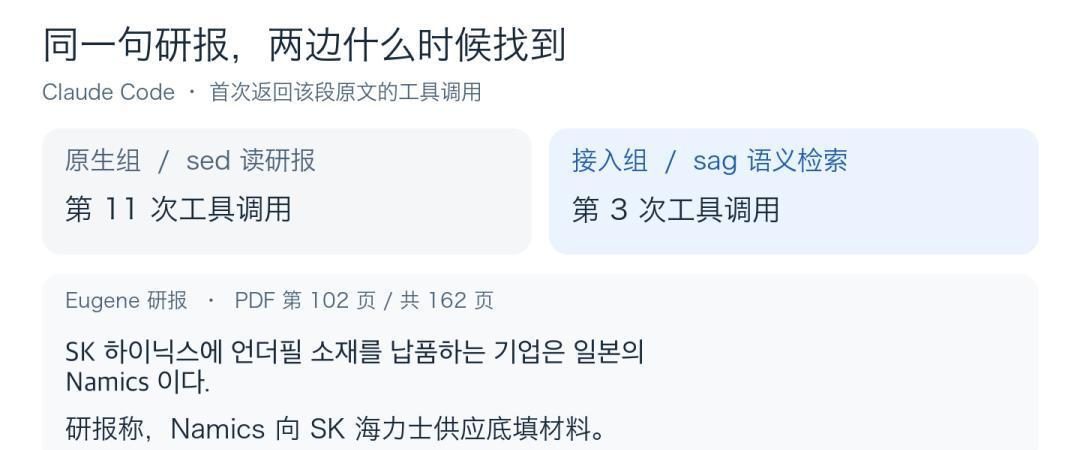
26 份半导体研报里查谁给 SK 海力士独家供 Underfill 胶水,SAG2 调用 3 次工具就命中 Namics,原生组翻到第 11 次才勉强蒙对。
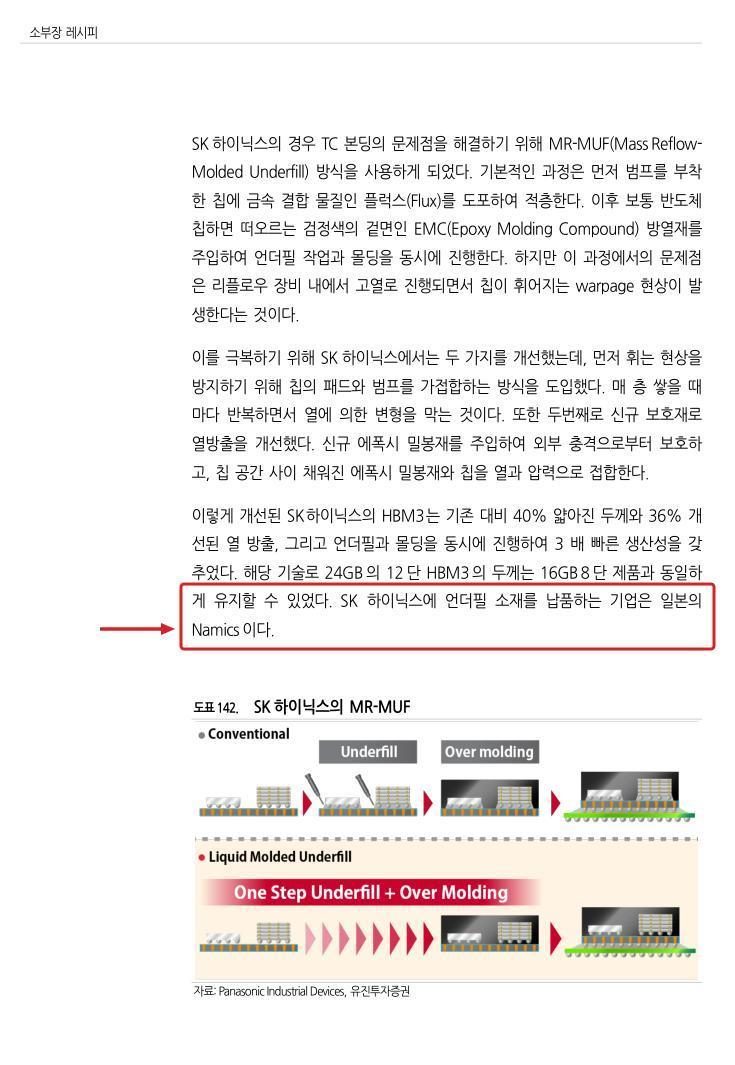
韩文半导体研报 PDF 第 102 页,红框标出「SK 하이닉스에 언더필 소재를 납품하는 기업은 일본의 Namics 이다」,即向 SK 海力士供应底部填充材料的是日本 Namics
26 份半导体研报里查「谁给 SK 海力士供 Underfill 胶水」,答案就在第 102 页这句韩文里
同一句研报的检索对比:原生组用 sed 读研报,到第 11 次工具调用才找到;接入组用 SAG 语义检索,第 3 次工具调用即命中
同一句研报:原生组第 11 次工具调用才翻到,接入 SAG 后第 3 次就命中

同一位作者还拿同一道代码题做了对照:接入 SAG Search 之后,完成用时从 144 秒降到 95 秒,工具调用从 53 次降到 39 次,Flash 累计 token 从 134.3 万降到 47.5 万。
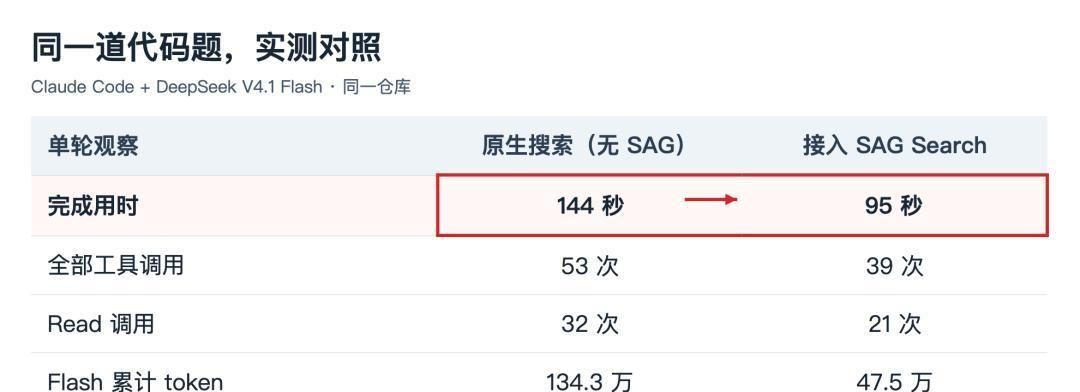
同一道代码题的实测对照表:原生搜索完成用时 144 秒、接入 SAG Search 为 95 秒;全部工具调用 53 次对 39 次;Read 调用 32 次对 21 次;Flash 累计 token 134.3 万对 47.5 万
同一道代码题、同一个仓库:接入 SAG Search 后用时从 144 秒降到 95 秒,token 消耗减少约三分之二
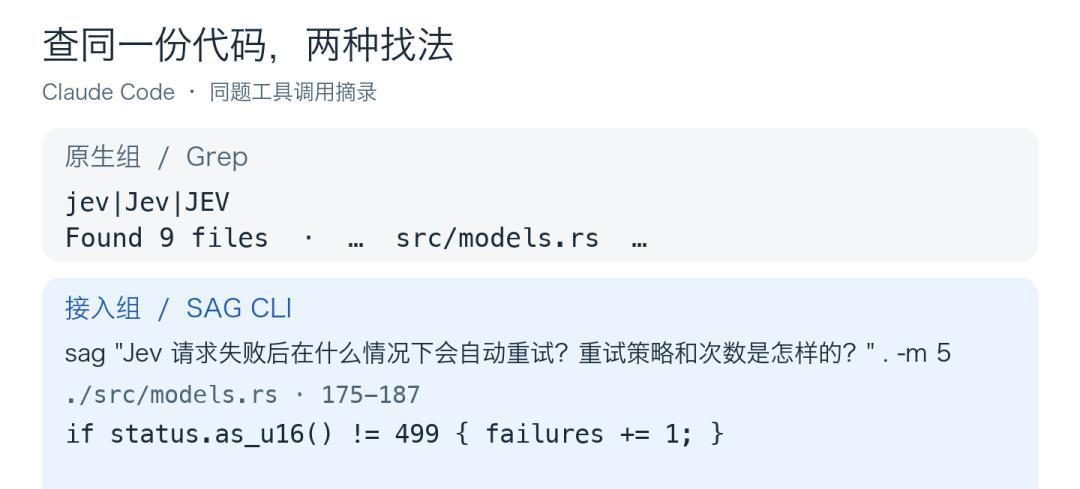
同一份代码的两种找法:原生组用 Grep 搜 jsev|Jev|JEV 命中 9 个文件;接入组用 sag 命令提问,直接定位到 src/models.rs 第 175 至 187 行
同一份代码的两种找法:Grep 命中 9 个文件还得逐个读,sag 一条命令直接指到行号
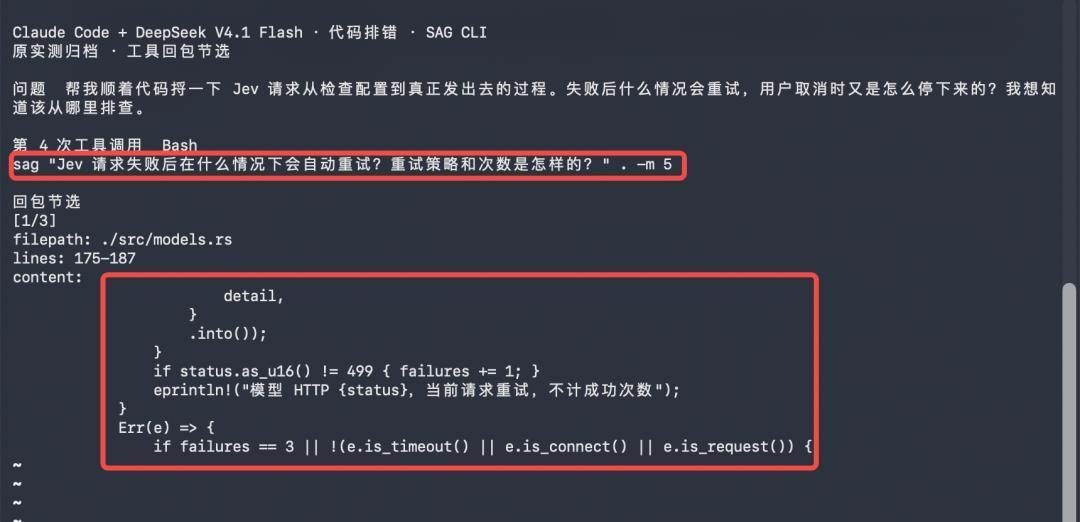
Claude Code 加 DeepSeek V4.1 Flash 的排错终端:第 4 次工具调用执行 sag 命令查 Jev 请求失败后的重试逻辑,返回 src/models.rs 第 175 至 187 行代码
把 SAG 接进 Claude Code 当工具用:问「Jev 请求失败后什么情况会重试」,第 4 次调用就取回了重试判断的源码
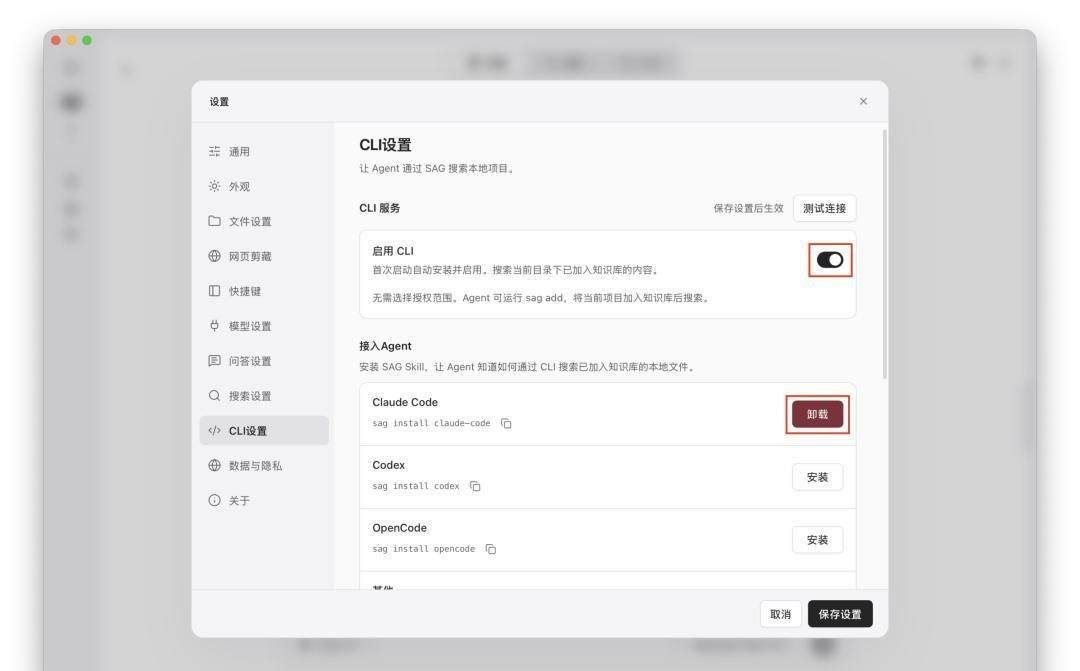
SAG Wiki 设置里的 CLI 设置页:可启用 CLI,并为 Claude Code、Codex、OpenCode 安装 SAG Skill
CLI 设置里一键给 Claude Code、Codex 装上 SAG Skill,Agent 就能检索已入库的本地文件
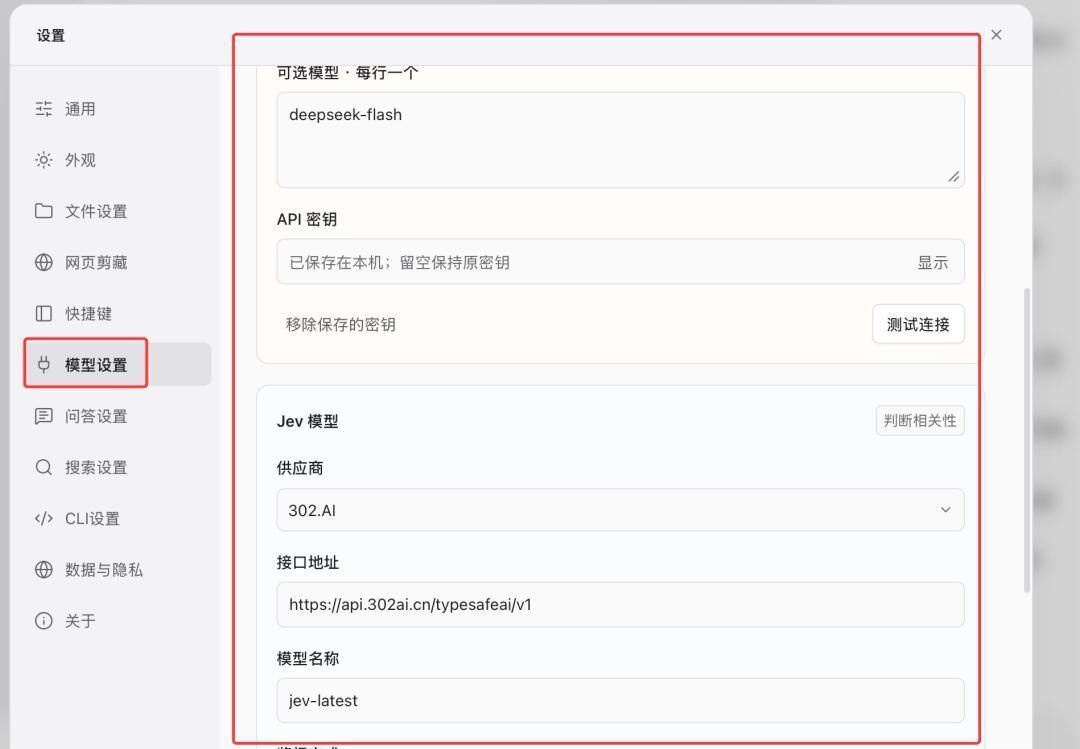
SAG Wiki 的模型设置页:对话模型填 deepseek-flash,API 密钥只保存在本机;Jev 模型供应商选 302.AI,接口地址 https://api.302ai.cn/typesafeai/v1,模型名 jev-latest
模型设置:对话模型与 Jev 判断模型分开配置,密钥只留在本机
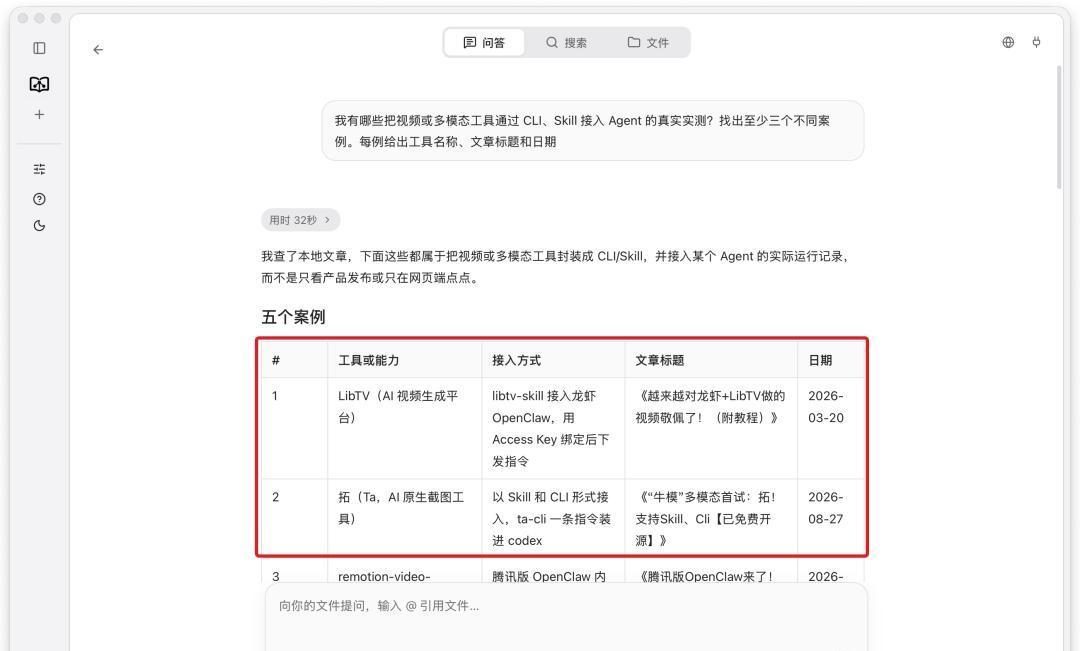
SAG Wiki 输出的五个案例表格,列出编号、工具或能力、接入方式、文章标题与日期,例如 LibTV、拓、remotion-video-generator
让它自己盘点「哪些多模态工具接进过 Agent」,它把五个案例连同接入方式、文章标题和日期一起列了出来

八、大道至简,全部开源

这套东西让我想起老子的话:大道至简,少则得,多则惑。大家卷参数、卷集群、卷向量库的时候,它退回到 Unix 那句「一切皆文件」。十几 MB 的体积,几秒钟的建库,多跳推理就这么平权到了每个人手里。

SAG2 和桌面端 SAG Wiki 已经全部开源。问个实际的:同样做本地知识库,一个要烧算力伺候,一个十几 MB 零预处理,你选哪个?
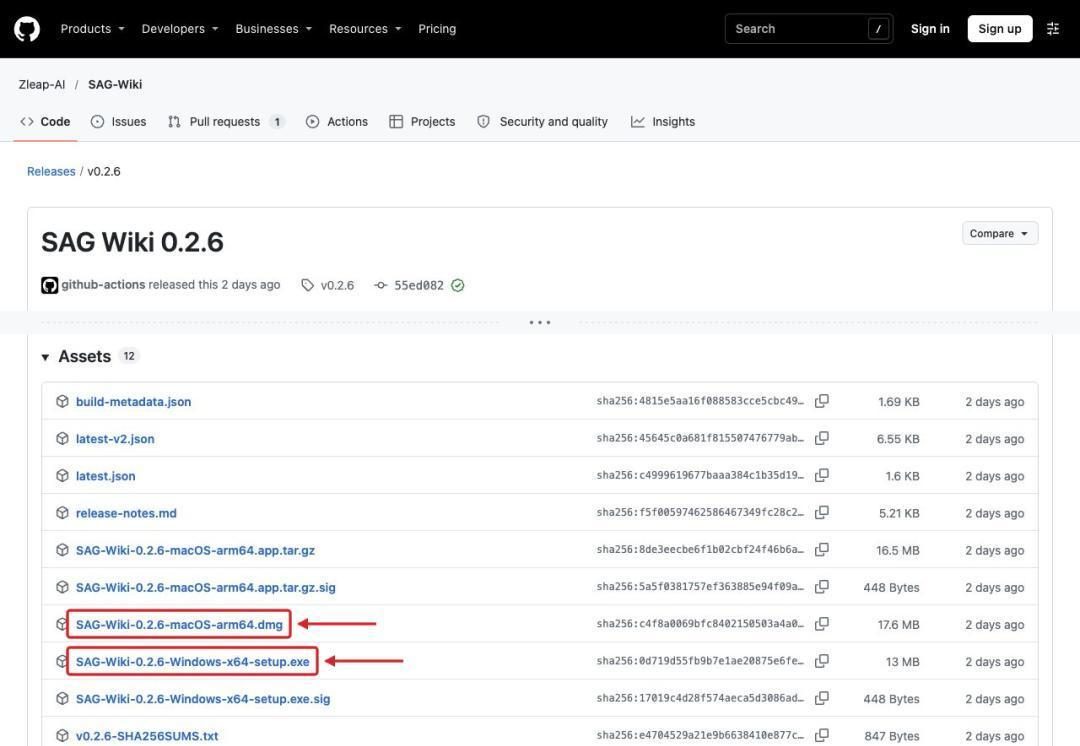
GitHub 上 Zleap-AI/SAG-Wiki 的 v0.2.6 发布页,Assets 里提供 macOS arm64 的 dmg 与 Windows x64 的 exe 安装包
SAG2 与桌面端 SAG Wiki 已在 GitHub 开源,v0.2.6 提供 macOS 与 Windows 安装包
资料说明:正文与配图整理自百度新闻转载的《别吹 RAG 了!本地知识库实测 SAG2 完胜,又快又准还便宜》(作者 山雀子,2026 年 11 月 7 日),文中截图已转存至本站媒体库;评测数字均出自原文与截图,未作改动。

让仓储与产线物流先一步智能化

告诉我们您的仓库形态、物料类型与产能目标,方案顾问会给出可落地的自动化路径。

400-9966-420